


مدخل إلى مشكلة ترميز النصوص
كثيراً ما يواجه مدراء الأنظمة ومهندسو البرمجيات نصوصاً وسجلات مشوهة أو غير مقروءة على خوادم لينكس نتيجة اختلاف مجموعات المحارف المستخدمة. في مثل هذه الحالات، تبرز الحاجة الماسة إلى تحديد معيار التشفير الفعلي للملف بدقة قبل محاولة معالجته. يستعرض هذا الدليل التطبيقي كيفية إعداد أداة chardetect، مع توضيح أساليب فحص الترميزات المختلفة وتحليل تدفقات البيانات وربطها بعمليات التحويل البرمجية.
تهيئة البيئة وتثبيت حزمة chardetect
نبدأ أولاً بتحديث فهارس المستودعات المحلية في النظام، ثم نثبت حزمة python3-chardet التي تزودنا بالأداة التنفيذية عبر سطر الأوامر.
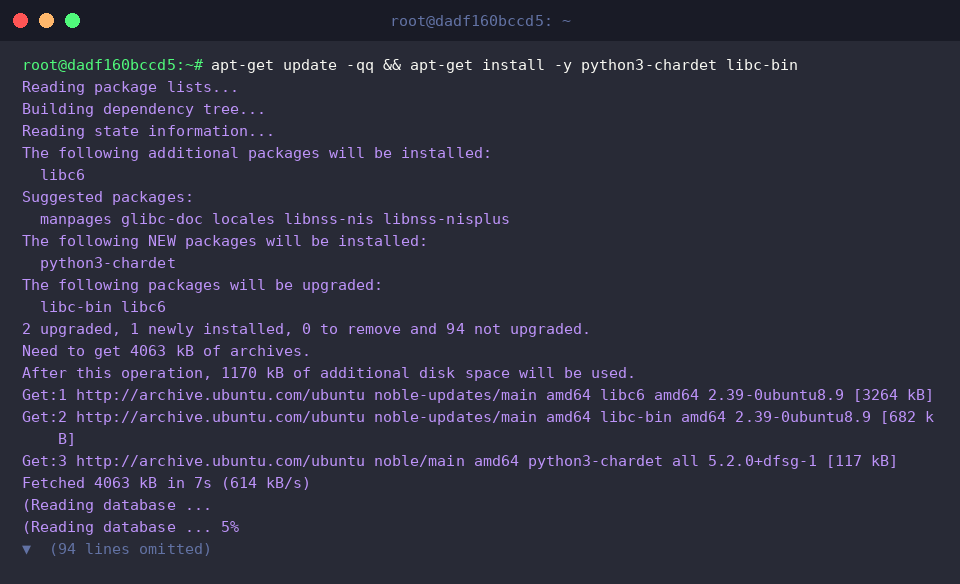
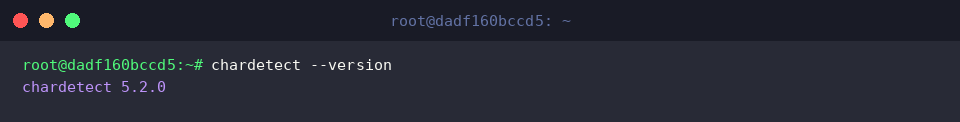
تعتمد أداة chardetect على خوارزميات إحصائية ذكية لتحليل تسلسل البايتات في الملفات أو تدفقات الدخل القياسي، وتستنتج نوع المحارف (Charset) ونسبة الثقة الإحصائية في تلك النتيجة. للتحقق من جاهزية الأداة، يمكن استدعاء خيار الإصدار --version.
⚙️ [خيارات التشغيل الأساسية]
-l, --line-per-line : يحلل تدفق النص سطراً بسطر بشكل مستقل بدلاً من قراءة الملف ككتلة واحدة.--minimal : يعرض اسم الترميز المكتشف فقط بصورة موجزة متجاهلاً نسبة الثقة الإحصائية.-h, --help : يعرض قائمة المساعدة التفصيلية وخيارات التحكم المتاحة.--version : يطبع رقم الإصدار الحالي للبرنامج ثم ينهي المعالجة.
توليد عينات نصية واختبار تمييز مجموعات المحارف
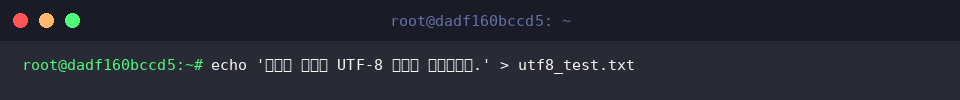
لإجراء فحص عملي واقعي، ننشئ مستنداً قياسياً مبنياً على ترميز UTF-8 يحمل الاسم utf8_test.txt عبر أمر echo.
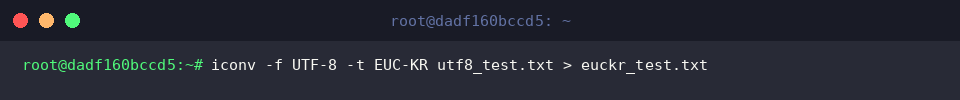
بهدف المقارنة ومعاينة استجابة الأداة لترميزات لغوية مختلفة، نستخدم برنامج iconv لتحويل المحتوى نفسه إلى ترميز كوري تقليدي EUC-KR وتخزينه باسم euckr_test.txt.
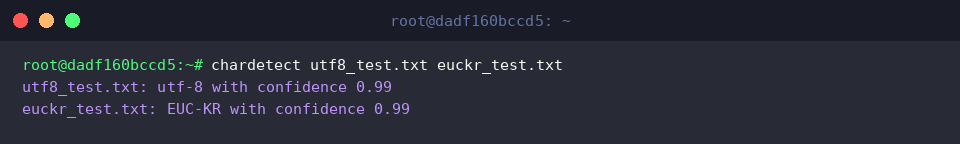
عند تمرير كلا الملفين معاً كوسائط لأمر chardetect، تفحص الأداة بنية كل ملف وتظهر نوع التشفير المكتشف مصحوباً بمعامل الدقة. تُظهر المعاينة تعرفاً دقيقاً على utf8_test.txt كترميز UTF-8 وعلى euckr_test.txt كترميز EUC-KR، مع نسبة ثقة بلغت 99% لكليهما.
معالجة التدفقات عبر الأنابيب والتحليل الجماعي لملفات السجلات
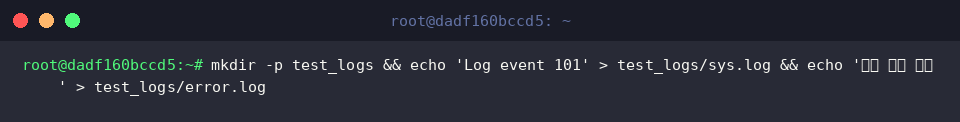
لمحاكاة مهام الصيانة اليومية وفحص السجلات، ننشئ دليلاً تجريبياً باسم test_logs يحتوي على ملفين، أحدهما يمثل سجلات نظام عامة والآخر يتضمن رسائل تنبيهية بأحرف خاصة: mkdir -p test_logs && echo 'Log event 101' > test_logs/sys.log && echo '서버 에러 로그' > test_logs/error.log.
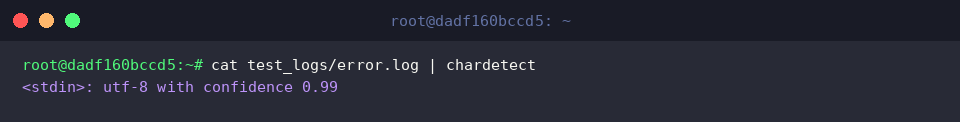
تتيح البيئة إمكانية دمج الأداة مع أنابيب لينكس القياسية (|)؛ فعبر توجيه خرج أمر cat مباشرة إلى chardetect، يتعامل البرنامج مع البيانات كمدخل قياسي <stdin> ويكتشف بنجاح ترميز UTF-8 بثقة مطلقة.
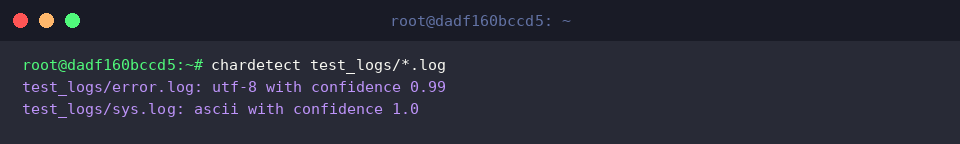
كما تساند الأداة المحارف البديلة (Wildcards مثل *)، مما يتيح استكشاف جميع سجلات الدليل دفعة واحدة. يُظهر الفحص الجماعي تمييزاً سليماً للملف الحاوي على محارف خاصة error.log بترميز UTF-8، في حين صُنّف ملف السجل الإنجليزي البحت sys.log كترميز ASCII قياسي.
المحرك الداخلي للأداة وإعادة الترميز عبر iconv
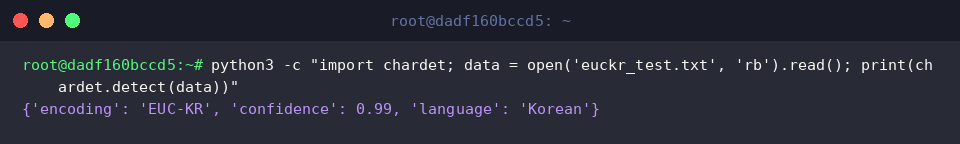
ترتكز أداة chardetect على مكتبة chardet الخاصة بلغة بايثون. باستدعاء هذه المكتبة برمجياً عبر سطر الأوامر، يمكننا معاينة تفاصيل الكشف التلقائي؛ حيث تُرجع المكتبة قاموساً يحوي الترميز المحتمل (EUC-KR)، ونسبة التأكد الرياضي (0.99)، وتصنيف اللغة الأصلية المحتملة (Korean).
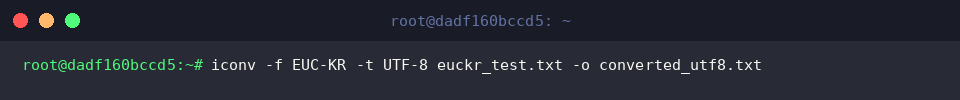
بناءً على نتائج التحليل السابقة، يمكن للمسؤول معالجة مشكلة التوافق وتحويل ملف euckr_test.txt إلى الصيغة المعيارية UTF-8 دون التخوف من تلف البيانات. نحدد تشفير المصدر عبر -f EUC-KR والتشفير المطلوب عبر -t UTF-8 مع حفظ المخرجات في converted_utf8.txt.
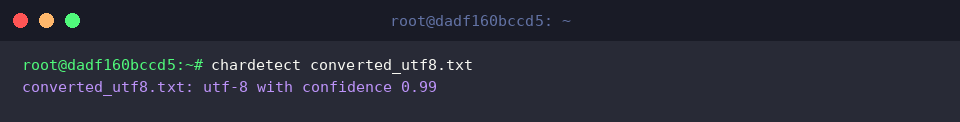
للتثبت النهائي من نجاح العملية، نمرر الملف المحول converted_utf8.txt مجدداً إلى chardetect. تُظهر النتيجة استقرار الترميز على معيار UTF-8 بدقة كاملة وموثوقية عالية.
ختاماً، يشكل أمر chardetect عنصراً حيوياً في ترسانة أدوات لينكس لتشخيص ومعالجة مشاكل الرموز المشوهة والغامضة بسرعة. تتيح لك هذه الآلية تحديد هوية النصوص قبل تعديلها لضمان تكامل البيانات واستقرار بيئات الخوادم.