


Introducción
En el ecosistema de administración de infraestructuras Linux, dominar la inspección de cargas de trabajo en tiempo real es una competencia crítica. Esta guía desglosa a fondo el funcionamiento del comando top, examinando desde la interpretación de sus paneles informativos hasta la aplicación práctica de modificadores avanzados y atajos de teclado para diagnosticar incidencias de rendimiento con agilidad.
Ejecución estándar y captura de instantáneas con el modo por lotes (Batch Mode)
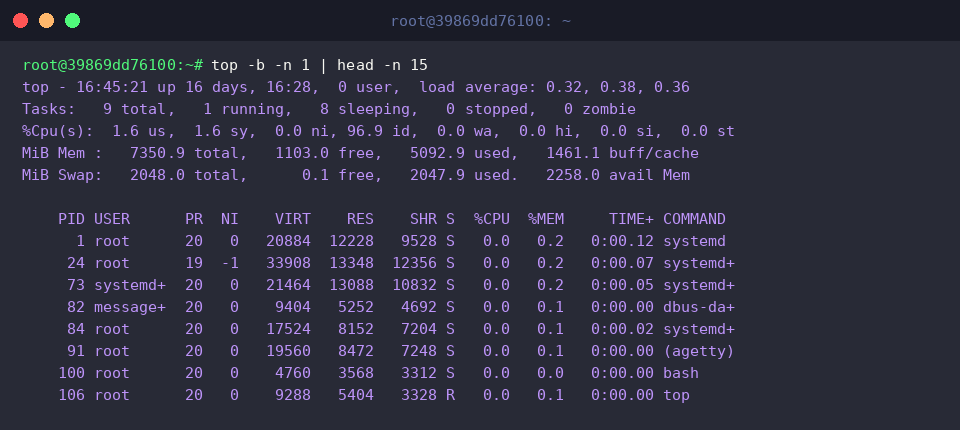
La herramienta top constituye el estándar por defecto en entornos Unix para supervisar el consumo de ciclos de procesador, la huella de memoria RAM y la tabla de procesos activos.
Si bien su interfaz dinámica interactiva es muy popular, combinar la modalidad de procesamiento por lotes (-b) con una cuota de ciclos determinada (-n 1) resulta ideal para auditorías automatizadas, registros históricos o scripts en bash. Al canalizar la salida hacia las primeras 15 líneas, obtenemos una radiografía inmediata de la carga media (load average) y los recursos globales.
⚙️ [Modificadores imprescindibles]
-b : Activa la modalidad por lotes (batch mode), suprimiendo los caracteres de control de terminal para volcar texto plano apto para redirecciones o tuberías.-n : Fija la cantidad exacta de iteraciones antes de finalizar el proceso automáticamente.-d : Determina el intervalo de refresco entre lecturas (expresado en segundos).-p : Delimita la supervisión exclusivamente a los identificadores de proceso (PID) indicados.-u : Restringe el listado para mostrar únicamente las tareas asociadas a una cuenta de usuario específica.-c : Sustituye el nombre abreviado del binario por la ruta completa y sus argumentos de arranque en la línea de comandos.
Aislamiento y seguimiento de procesos por cuenta de usuario
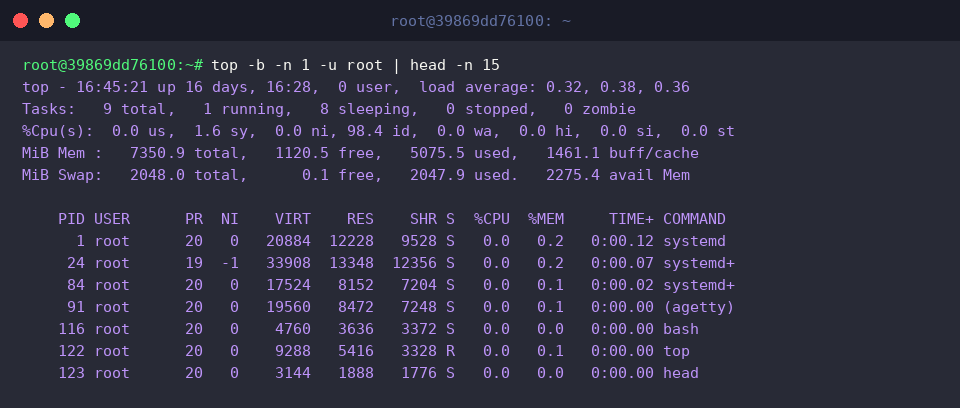
Al administrar servidores multiusuario o plataformas de despliegue, resulta prioritario aislar el consumo computacional de cuentas concretas. Con el parámetro -u es posible segmentar la salida omitiendo cualquier tarea ajena.
Al ejecutar top -b -n 1 -u root | head -n 15, el sistema expone exclusivamente los servicios y demonios ejecutados con privilegios del superusuario root, permitiendo auditar el impacto de los procesos de infraestructura en las 15 filas superiores.
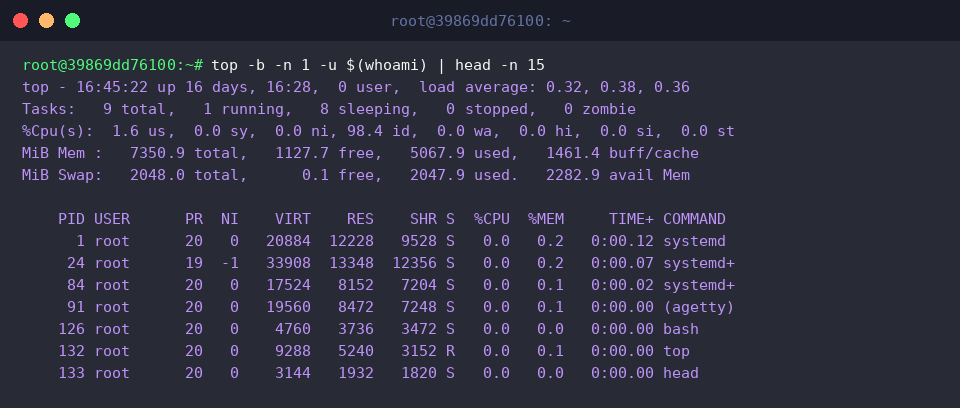
Para evitar introducir credenciales manualmente, podemos acoplar la sustitución de comandos mediante $(whoami), inyectando el identificador de la sesión activa en el flujo de inspección.
El comando top -b -n 1 -u $(whoami) | head -n 15 sintetiza con precisión las tareas originadas por el operador actual, facilitando la evaluación directa de sus consumos.
Seguimiento focalizado de un PID específico y configuración de frecuencias de muestreo
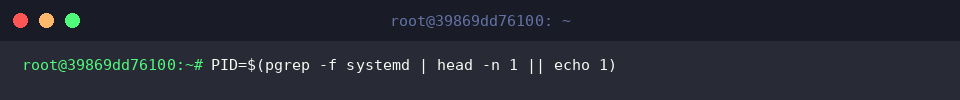
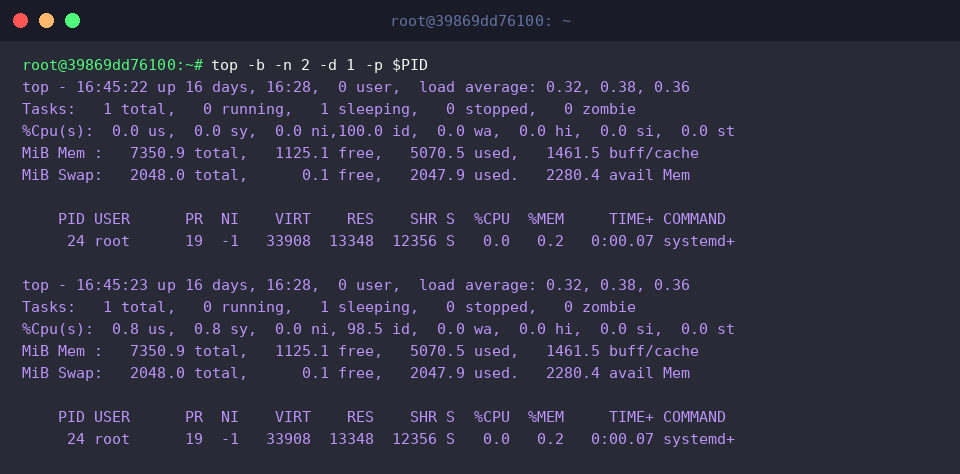
Cuando se investiga un servicio problemático, aislar su identificador de proceso (PID) optimiza el análisis. Para recuperar dicho valor sin fricciones, ejecutamos PID=$(pgrep -f systemd | head -n 1 || echo 1), asignando el PID de systemd a una variable de entorno de shell.
Una vez parametrizado el objetivo, la instrucción top -b -n 2 -d 1 -p $PID instruye a la utilidad a recolectar dos muestras consecutivas (-n 2) espaciadas por una pausa de un segundo (-d 1), focalizándose solo en $PID.
Este procedimiento ofrece un registro cronológico continuo para evidenciar anomalías, fugas de memoria o fluctuaciones bruscas de CPU sin la interferencia del resto de tareas concurrentes.
Detección de cuellos de botella: ordenación por memoria física (RES) y uso de procesador
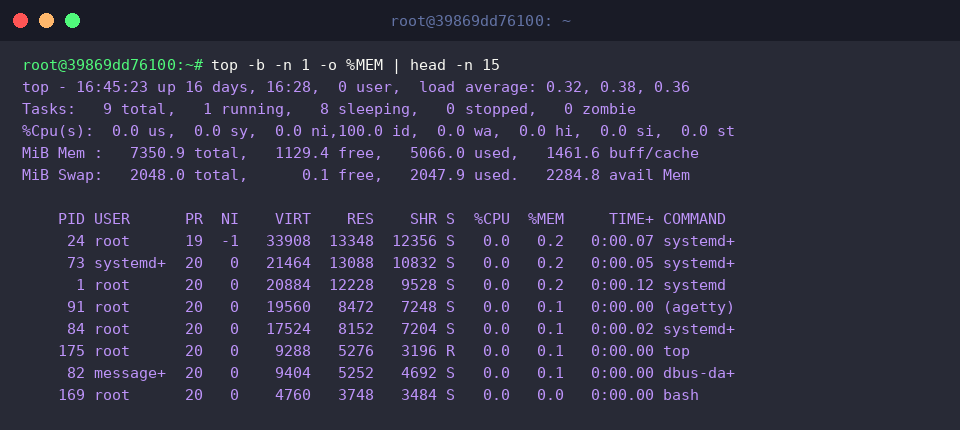
Detectar qué elemento está saturando la memoria del sistema es esencial para prevenir que el mecanismo Out-of-Memory Killer (OOM) aborte servicios críticos. Al ejecutar top -b -n 1 -o %MEM | head -n 15, reordenamos la lista de mayor a menor consumo de RAM (%MEM), dejando al descubierto los mayores consumidores de memoria residente (RES).
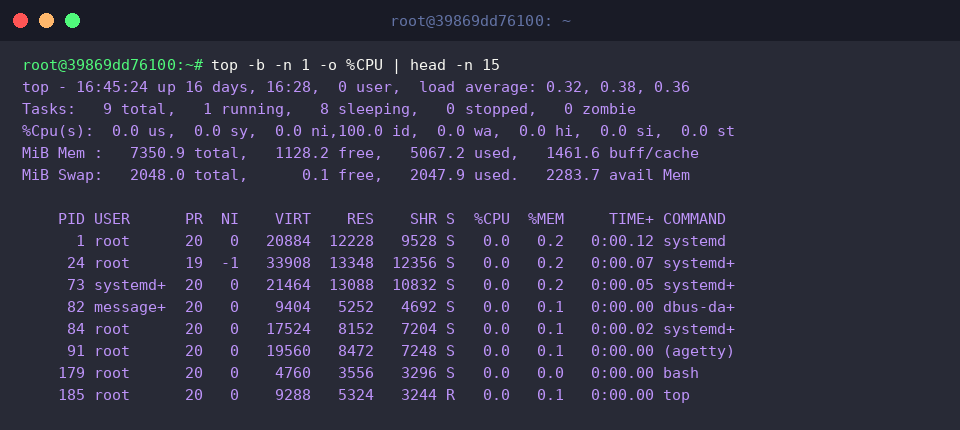
Por otro lado, cuando la métrica de carga (Load Average) escala súbitamente debido a cómputo intensivo, el comando top -b -n 1 -o %CPU | head -n 15 permite reorganizar las entradas en función del porcentaje de procesador (%CPU).
Esta instrucción aísla en segundos los hilos que monopolizan los núcleos de la máquina, permitiendo intervenir antes de que se produzca una degradación general del servicio.
Con esta serie de parámetros y metodologías de diagnóstico, dispones de una base sólida para inspeccionar el estado de tus servidores Ubuntu con total precisión. Implementar estas técnicas te garantizará una administración proactiva, asegurando la estabilidad y el rendimiento óptimo de tu infraestructura.