


Introducción
En el ecosistema de administración de servidores Linux y arquitectura de software, la utilidad curl representa un pilar indiscutible para interactuar con la red. Este manual aborda su implementación práctica en escenarios reales de producción: desde consultas HTTP básicas y depuración de microservicios REST, hasta la inspección minuciosa de cabeceras y la transferencia ininterrumpida de archivos de gran volumen.
1. Puesta a punto y primeras peticiones HTTP (Método GET)
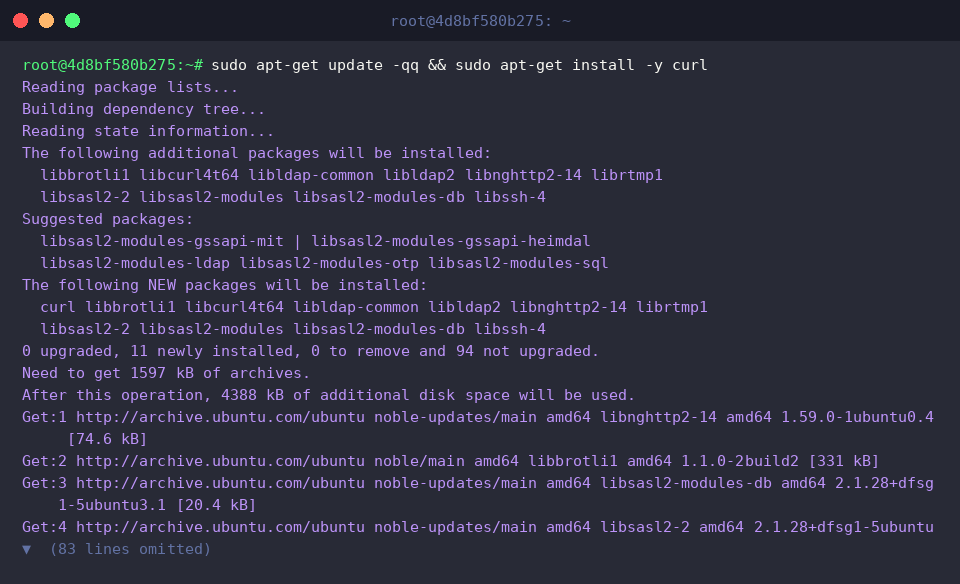
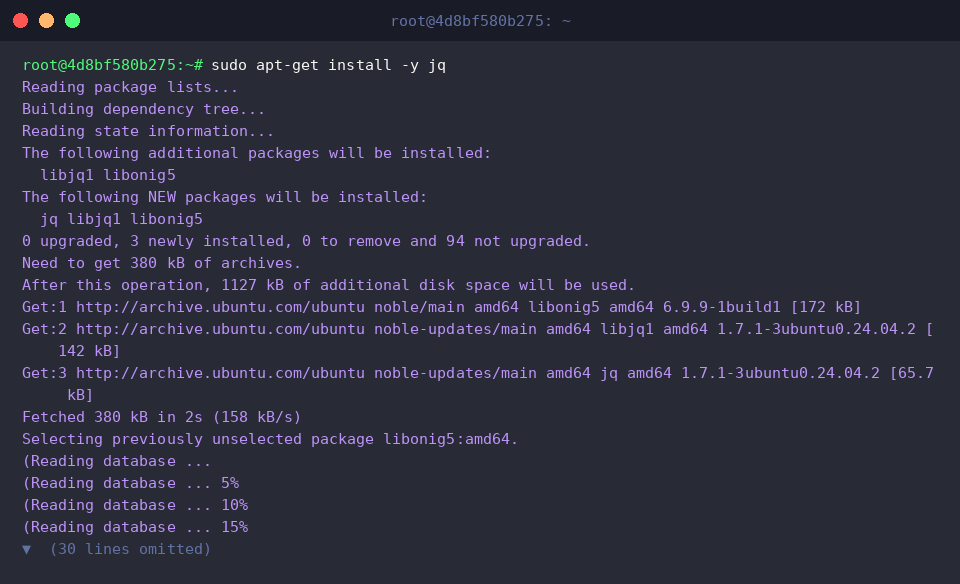
Antes de iniciar el laboratorio, aseguramos que el catálogo de repositorios de la distribución esté sincronizado y procedemos con el despliegue del binario en el sistema.
Concebido como un motor multiprotocolo de transferencia por red, curl resuelve y procesa recursos referenciados mediante URI.
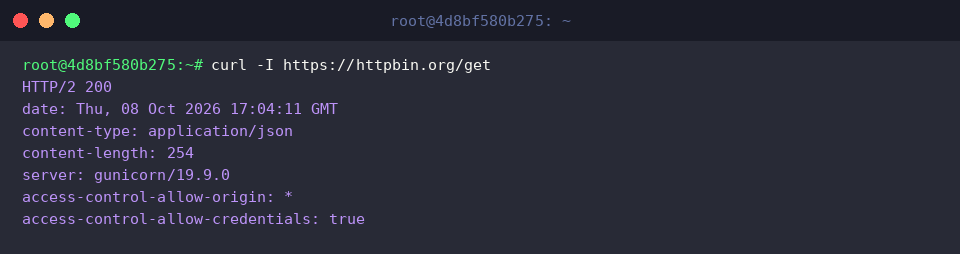
Al invocarlo pasando únicamente la dirección de destino, el comando genera de forma predeterminada una petición HTTP GET convencional y vuelca el cuerpo (body) de la respuesta de vuelta a la salida estándar (stdout) de la consola.
⚙️ [Parámetros operacionales clave]
-s : Modo silencioso (silent); suprime medidores de progreso, diagnósticos menores y mensajes de error.-i : Adjunta las cabeceras HTTP emitidas por el servidor justo antes del cuerpo de la respuesta.-I : Modo cabecera (HEAD); solicita e imprime únicamente los encabezados del servidor, omitiendo la descarga del payload.-X : Establece explícitamente el verbo o método HTTP de la transacción (GET, POST, PUT, DELETE, etc.).-d : Adjunta el cuerpo de datos (payload/body) destinado al servidor, común en solicitudes HTTP POST.-H : Incorpora encabezados HTTP personalizados a la solicitud en curso.-o : Dirige la corriente de datos descargada hacia un archivo local con el nombre que indiquemos.-O : Almacena el recurso en disco reteniendo exactamente el nombre remoto original presente en la URL.-C - : Habilita la reanudación automática (resume offset) en transferencias interrumpidas.-L : Fuerza al cliente a seguir automáticamente cualquier redireccionamiento HTTP de la serie 3xx hasta la URL definitiva.
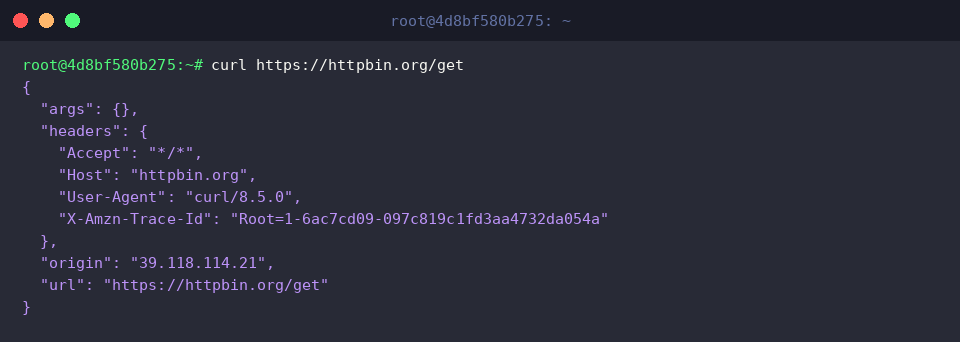
La activación del flag -s desactiva cualquier telemetría visual, evitando que medidores de tasa de transferencia o advertencias contaminen la salida.
Esta presentación depurada es indispensable al encadenar comandos mediante tuberías (pipes |) o integrar peticiones dentro de scripts Bash desatendidos.
2. Inspección de encabezados y verificación de códigos de estado HTTP
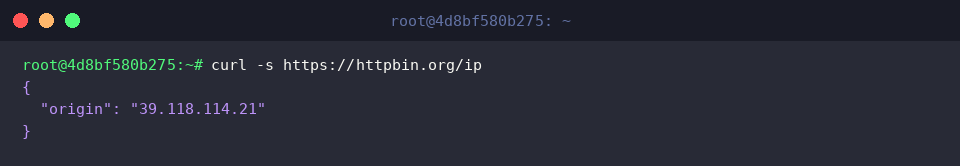
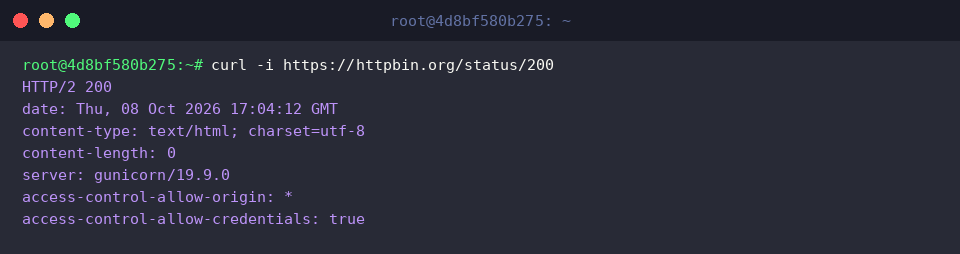
Cuando requerimos evaluar el comportamiento de un servidor sin incurrir en transferencias innecesarias de ancho de banda, el parámetro -I permite enviar una solicitud ligera para extraer únicamente las cabeceras.
Resulta óptimo para auditar de forma inmediata el protocolo negociado, directivas de compresión, tipos MIME (Content-Type) o el estado de respuesta (HTTP/2 200).
Si el objetivo consiste en depurar una API analizando en simultáneo tanto el contenido retornado como los metadatos de respuesta, el parámetro -i conserva íntegros los encabezados HTTP previos al cuerpo del mensaje.
Esta perspectiva unificada acelera significativamente la resolución de anomalías en llamadas a endpoints.
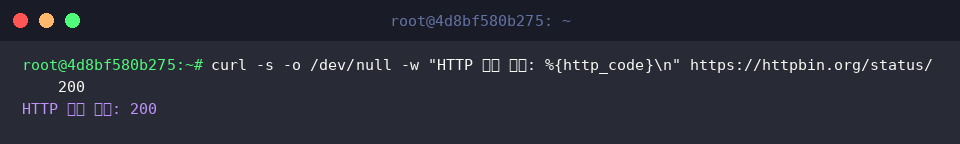
Una técnica avanzada para health checks y validaciones en pipelines de CI/CD consiste en silenciar la salida (-s), descartar el contenido en el sumidero del sistema (-o /dev/null) y formatear exclusivamente el código numérico final mediante -w.
De este modo, se obtienen variables limpias para controlar bifurcaciones lógicas y estructuras condicionales en scripts de automatización.
3. Interacción con APIs REST y mecanismos de autenticación (Peticiones POST y JSON)
Para manipular estructuras JSON devueltas por los endpoints de forma estructurada, limpia y legible dentro del entorno de línea de comandos, incorporamos la utilidad jq.
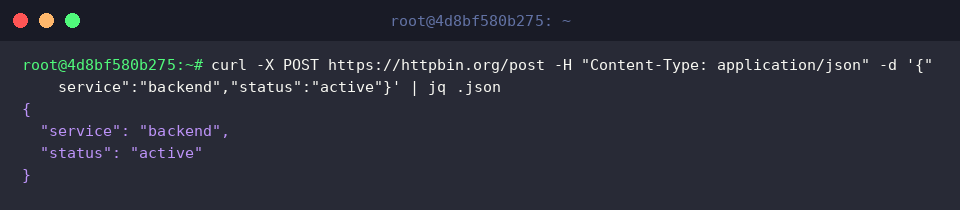
Al consumir interfaces REST, combinamos -X POST para fijar la acción, -H "Content-Type: application/json" para definir el tipo de payload y -d para adjuntar la carga útil serializada.
Redirigiendo la respuesta hacia jq mediante un pipe (|), verificamos al instante que el backend haya parseado e interpretado correctamente los atributos enviados.
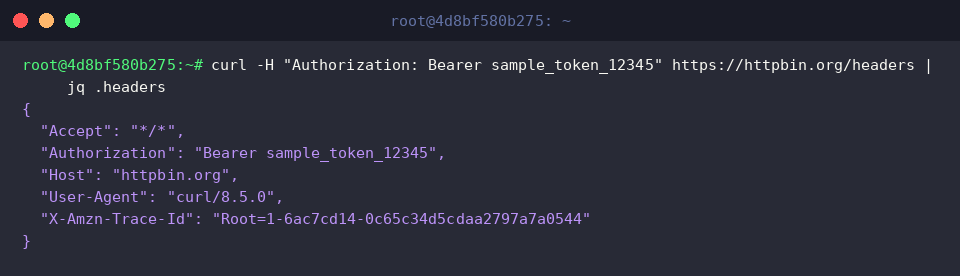
Los entornos seguros exigen credenciales de acceso; para estos flujos, inyectamos la cabecera correspondiente con el parámetro -H, adoptando esquemas como Authorization: Bearer <token>.
Esta sintaxis permite validar la correcta propagación de identificadores de sesión, claves API o tokens JWT hacia servicios protegidos.
4. Gestión avanzada de descargas: Almacenamiento local y reanudación de transferencias
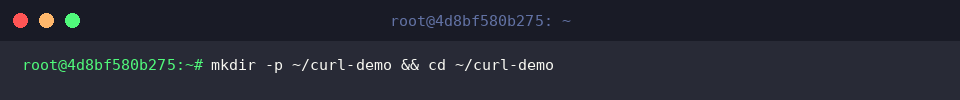
Para aislar nuestras pruebas de persistencia de archivos, configuramos un directorio de trabajo específico y nos situamos dentro de él.
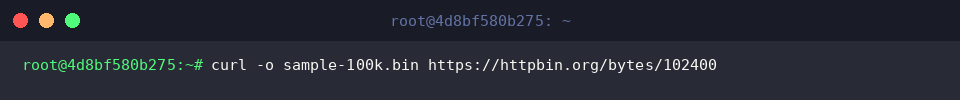
Al volcar archivos binarios o paquetes, el modificador -o previene que los bytes crudos corrompan la visualización del emulador de terminal, encauzando la información hacia un nombre de archivo definido como sample-100k.bin.
Este método garantiza un resguardo predecible y seguro de cualquier artefacto descargado.
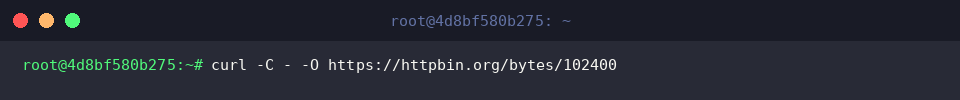
Frente a redes inestables o transferencias de gigabytes, combinar -C - con -O aporta tolerancia a fallos: el cliente detecta el tamaño del fragmento ya presente en disco y continúa exactamente donde se cortó la sesión, preservando a su vez el nombre original del archivo remoto.
Esto elimina la necesidad de reiniciar transferencias extensas desde cero, optimizando sustancialmente el consumo de red y tiempo.
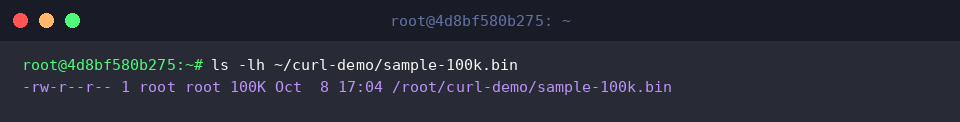
Para corroborar la integridad de la operación, ejecutamos ls -lh e inspeccionamos los metadatos de sample-100k.bin, certificando que el tamaño final en disco coincida con la cuota prevista.
Hemos recorrido las funciones operativas más relevantes de curl en entornos Linux, abarcando desde solicitudes web elementales y diagnósticos de servicios REST hasta la orquestación de descargas resistentes a fallos.
Incorporar estos modificadores en sus flujos diarios de trabajo reforzará la fiabilidad y eficiencia de sus scripts y tareas de administración técnica.