


Introducción y contexto técnico
El problema del texto corrupto o caracteres ilegibles (mojibake) suele surgir con frecuencia al inspeccionar registros del sistema o transferir ficheros entre plataformas heterogéneas en entornos GNU/Linux. En tales escenarios, determinar la codificación exacta de los datos resulta indispensable antes de procesarlos. En este artículo profundizaremos en el despliegue práctico de la utilidad chardetect, explorando desde su instalación y casos de uso comunes hasta su lógica algorítmica interna.
Instalación y primeros pasos con chardetect
Para comenzar a operar con esta utilidad en distribuciones derivadas de Debian o Ubuntu, sincronizamos los repositorios del gestor de paquetes e instalamos el binario provisto por la biblioteca python3-chardet.
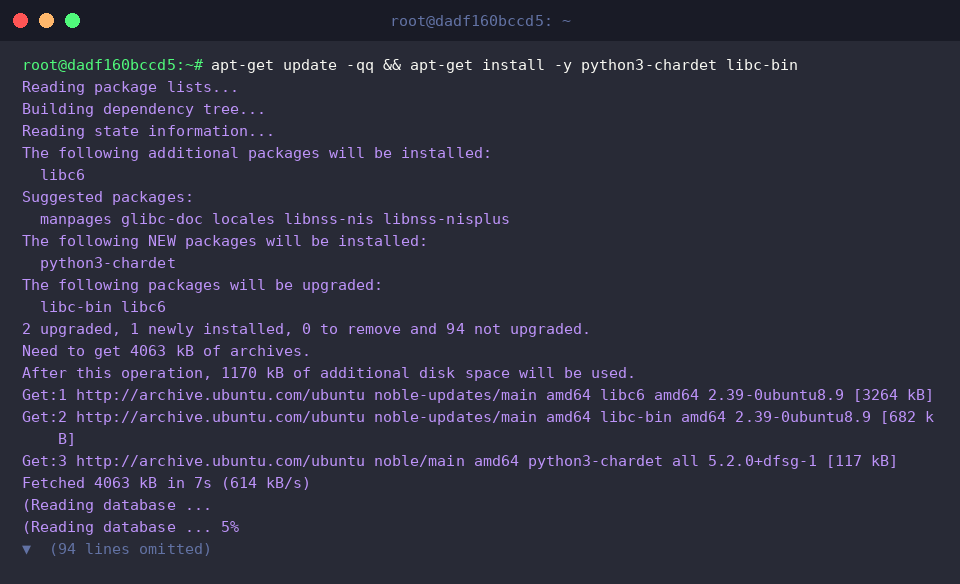
El comando chardetect examina secuencias de bytes procedentes de ficheros o flujos de datos estándar para inferir el juego de caracteres subyacente, reportando tanto la codificación estimada como un índice estadístico de fiabilidad.
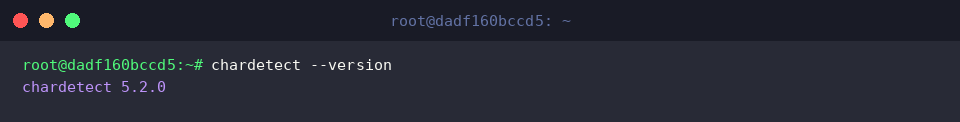
El modificador --version permite comprobar la versión del paquete desplegada en el entorno.
⚙️ [Parámetros de ejecución frecuentes]
-l, --line-per-line : Examina y desglosa el juego de caracteres de manera independiente para cada línea del documento.--minimal : Suprime las métricas de confianza y devuelve exclusivamente la denominación del conjunto de caracteres detectado.-h, --help : Despliega la documentación integrada junto con los modificadores admitidos.--version : Muestra el identificador de versión del software y finaliza la ejecución.
Generación de ficheros de prueba y análisis de juegos de caracteres
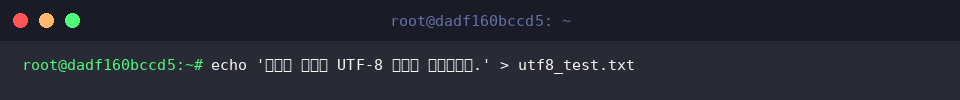
Para evaluar la precisión del analizador, generamos inicialmente un documento codificado de forma nativa en UTF-8 mediante la instrucción echo.
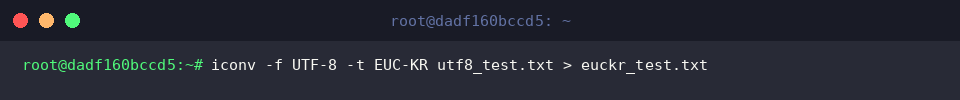
Con el propósito de contrastar la detección entre formatos dispares, recurrimos a la herramienta iconv para transformar el fichero previo a la codificación multibyte EUC-KR, almacenando el resultado en euckr_test.txt.
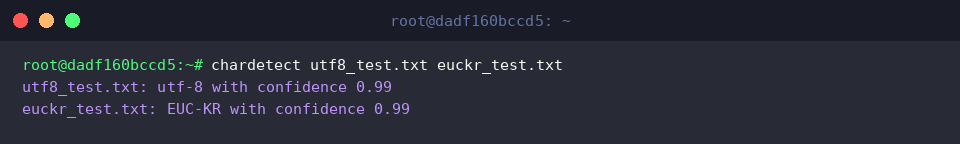
Al pasar ambos ficheros como argumentos consecutivos a chardetect, el programa evalúa sus cabeceras y secuencias de bytes, emitiendo la etiqueta del estándar detectado junto a su probabilidad.
La salida ratifica la eficacia del motor heurístico: utf8_test.txt se categoriza como UTF-8 y euckr_test.txt como EUC-KR, alcanzando en ambos análisis un índice de certidumbre del 99%.
Procesamiento en lote e integración mediante canalizaciones (pipes)
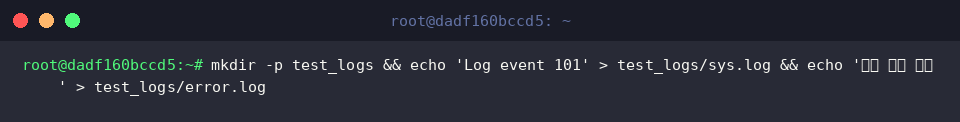
Para simular una estructura típica de monitorización de servidores, creamos un subdirectorio con dos volcados de eventos de prueba mediante mkdir -p test_logs && echo 'Log event 101' > test_logs/sys.log && echo '서버 에러 로그' > test_logs/error.log.
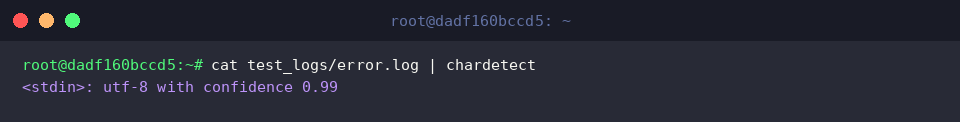
Es viable canalizar la salida de herramientas como cat hacia chardetect a través del operador de tubería (|), permitiendo auditar flujos de datos dinámicos sin persistirlos previamente en disco.
Al operar sobre el descriptor estándar, la utilidad identifica la fuente como <stdin> y dictamina la presencia de UTF-8 con una certidumbre de 0.99.
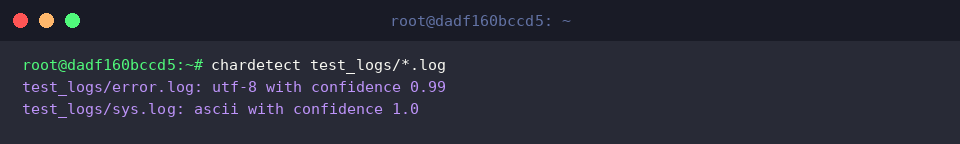
Asimismo, la sintaxis admite comodines (*) del intérprete de comandos para inspeccionar simultáneamente colecciones completas de ficheros de registro.
En esta prueba masiva, el archivo error.log (que almacena caracteres coreanos) se clasifica acertadamente como UTF-8, mientras que sys.log (compuesto únicamente por texto en inglés) se identifica de manera óptima bajo la norma ASCII.
Mecanismo interno y conversión de formatos con iconv
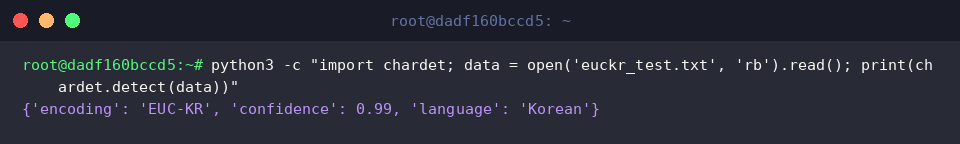
Por debajo de la interfaz de consola, la herramienta se apoya en el módulo de Python homónimo. Si invocamos directamente la API programática sobre los bytes en bruto de euckr_test.txt, podemos apreciar la estructura de datos que sustenta las deducciones.
El resultado expone un diccionario que detalla el formato identificado (EUC-KR), el coeficiente estadístico (0.99) y el idioma inferido (Korean).
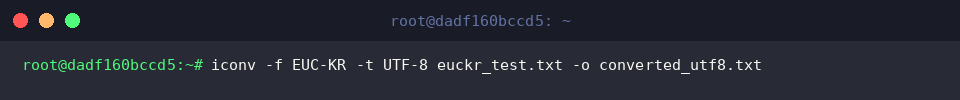
Una vez confirmada la codificación de origen, podemos emplear iconv para homogeneizar el contenido hacia el estándar universal UTF-8.
Definiendo -f EUC-KR para el formato fuente y -t UTF-8 para el de destino mediante la opción -o, generamos converted_utf8.txt preservando la integridad tipográfica de los textos originales.
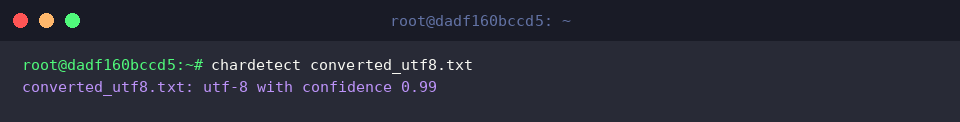
Para validar el resultado de la transformación, sometemos el nuevo fichero converted_utf8.txt a una última verificación con chardetect.
El informe confirma que la recodificación a UTF-8 concluyó con total éxito, arrojando una fiabilidad máxima del 99%.
Dominar el uso de chardetect junto con herramientas de conversión estándar como iconv constituye un recurso esencial en la administración de sistemas para solventar problemas de codificación y asegurar un flujo de trabajo fiable en entornos Linux.