


Introducción y panorama general
Examinar discrepancias y coincidencias textuales entre pares de ficheros constituye una tarea cotidiana en la administración de sistemas Linux. En este tutorial exploraremos a fondo la utilidad comm, una herramienta ligera del estándar POSIX diseñada para cotejar flujos de texto de forma tabular. Desde su desglose clásico en tres columnas hasta la manipulación de conjuntos lógicos (unión, intersección y diferencias relativas), pasando por flujos no ordenados en Bash, descubrirás cómo optimizar el cotejo de registros y listas de datos sin recurrir a scripts complejos.
1. Fundamentos de comm y la estructura de salida en tres columnas
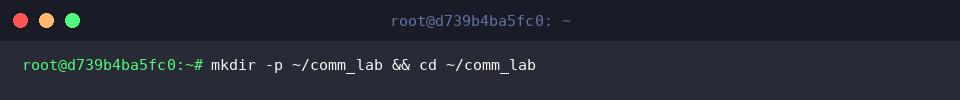
Para garantizar un entorno limpio y aislado durante nuestras pruebas, inicializamos un directorio dedicado en el espacio de usuario y accedemos a él mediante mkdir -p ~/comm_lab && cd ~/comm_lab.
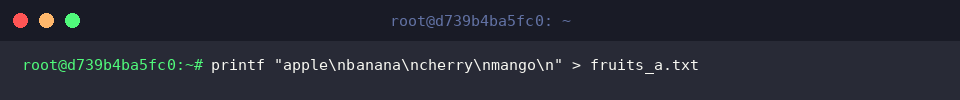
Como primer paso, generamos un conjunto de datos base ya clasificado alfabéticamente; creamos el archivo fruits_a.txt ejecutando printf "apple\nbanana\ncherry\nmango\n" > fruits_a.txt.
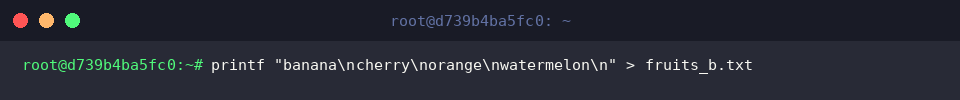
A continuación, producimos el segundo fichero de referencia, fruits_b.txt, que compartirá ciertos elementos e incorporará otros nuevos, mediante printf "banana\ncherry\norange\nwatermelon\n" > fruits_b.txt.
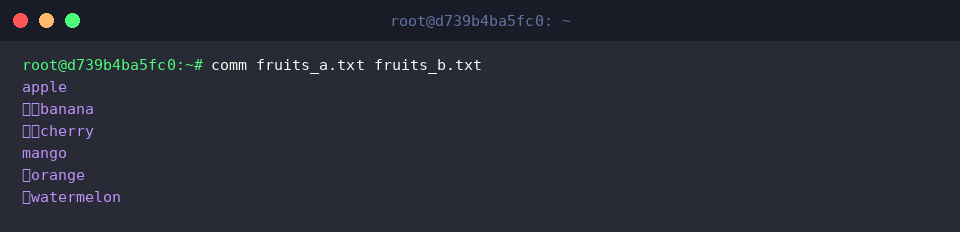
La utilidad comm evalúa de forma síncrona ambos ficheros ordenados, distribuyendo el resultado en un esquema de tres columnas delimitadas por tabulaciones:
El primer nivel (sin sangría inicial) expone las líneas exclusivas del primer fichero; la segunda columna (desplazada por un tabulador) muestra el contenido presente únicamente en el segundo fichero; por último, la tercera columna (con doble sangría) refleja los registros compartidos por ambas fuentes.
⚙️ [Parámetros destacados]
-1 : Suprime del reporte visual la columna 1 (entradas exclusivas del primer archivo).-2 : Oculta la columna 2 (entradas exclusivas del segundo archivo).-3 : Descarta la columna 3 (entradas coincidentes en ambos archivos).--check-order : Verifica activamente que las entradas suministradas sigan una estricta ordenación previa.--nocheck-order : Deshabilita la comprobación interna de clasificación en los ficheros de entrada.--output-delimiter=STR : Reemplaza la tabulación por defecto insertando la cadena personalizada (STR) como separador de columnas.
2. Filtrado de intersecciones y diferencias relativas mediante flags numéricos
Retomamos la ubicación de pruebas en nuestra terminal asegurando la ruta de trabajo con cd ~/comm_lab.
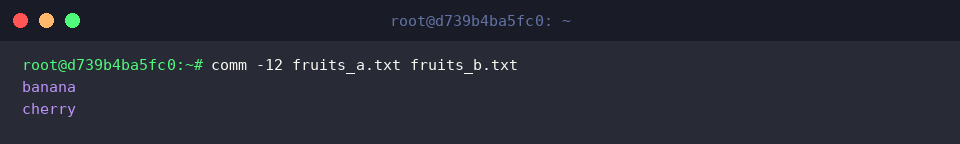
Al combinar las banderas numéricas en la sintaxis comm -12, se descartan simultáneamente los valores únicos de cada archivo, aislando exclusivamente la intersección de datos.
Como resultado directo del análisis, la consola despliega únicamente los elementos comunes: banana y cherry.
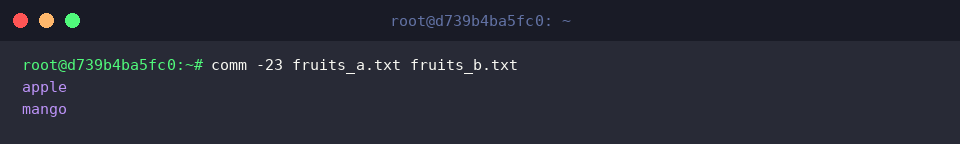
Por otra parte, recurrir a comm -23 inhibe las columnas dos y tres, permitiendo segregar únicamente la diferencia simétrica correspondiente al conjunto inicial.
El comando imprime así exclusivamente apple y mango, pertenecientes de forma estricta a fruits_a.txt.
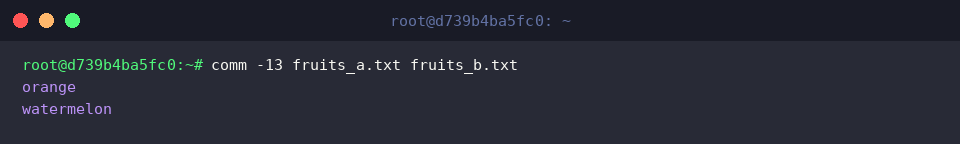
Siguiendo esta misma lógica de supresión, la ejecución de comm -13 enmascara la primera y la tercera columna para exponer únicamente la porción privativa del segundo conjunto.
En esta ocasión obtenemos orange y watermelon, registrados únicamente en el archivo fruits_b.txt.
3. Procesamiento de archivos desordenados: sustitución de procesos en Bash
Nos cercioramos de permanecer en la carpeta de experimentación ejecutando cd ~/comm_lab.
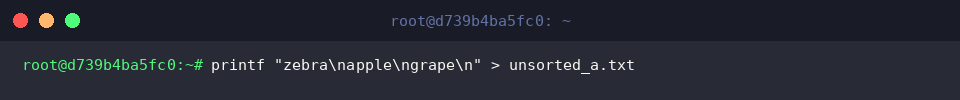
Dado que comm exige colecciones rigurosamente ordenadas para operar con exactitud, preparamos un archivo desclasificado denominado unsorted_a.txt mediante el comando printf "zebra\napple\ngrape\n" > unsorted_a.txt.
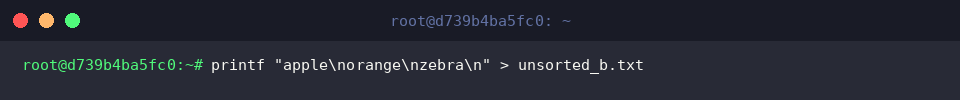
De forma análoga, generamos un segundo fichero con elementos fuera de orden léxico ejecutando printf "apple\norange\nzebra\n" > unsorted_b.txt.
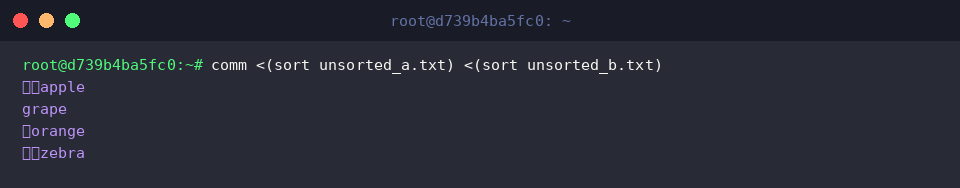
En lugar de reescribir los ficheros o crear intermediarios en disco, aplicamos la sustitución de procesos de Bash con comm <(sort unsorted_a.txt) <(sort unsorted_b.txt), alimentando las entradas de comm con descriptores en memoria generados al vuelo por sort.
El flujo resultante se interpreta impecablemente: grape aparece en la columna 1, orange en la columna 2, y los valores compartidos apple y zebra se alojan ordenados en la columna 3.
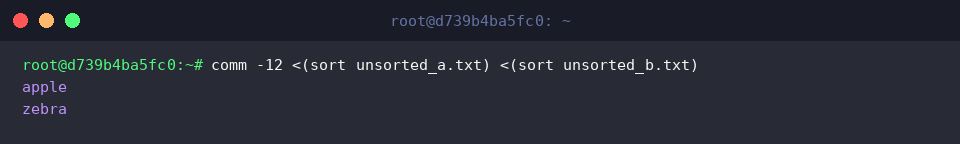
Si requerimos únicamente los puntos de contacto entre ambas fuentes caóticas, combinamos la sustitución con la bandera de intersección: comm -12 <(sort unsorted_a.txt) <(sort unsorted_b.txt).
La terminal retorna de inmediato los elementos coincidentes apple y zebra, eliminando discrepancias sin haber tocado el estado original del almacenamiento persistente.
4. Casos prácticos de administración: listas de paquetes y matices de mayúsculas
Nos situamos nuevamente en el entorno de pruebas ingresando cd ~/comm_lab.
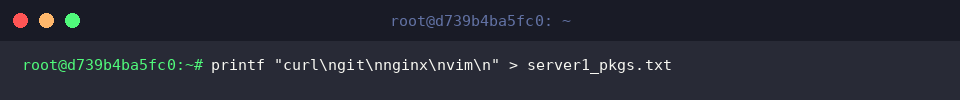
Imaginemos una auditoría entre dos instancias de producción; para recrearla, volcamos el inventario de software del primer nodo en server1_pkgs.txt con printf "curl\ngit\nnginx\nvim\n" > server1_pkgs.txt.
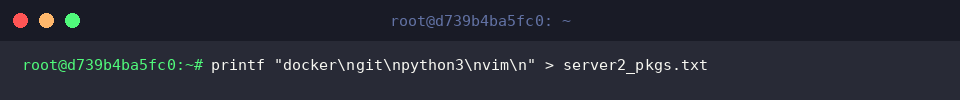
Acto seguido, registramos el perfil de paquetes correspondiente al segundo servidor en server2_pkgs.txt corriendo printf "docker\ngit\npython3\nvim\n" > server2_pkgs.txt.
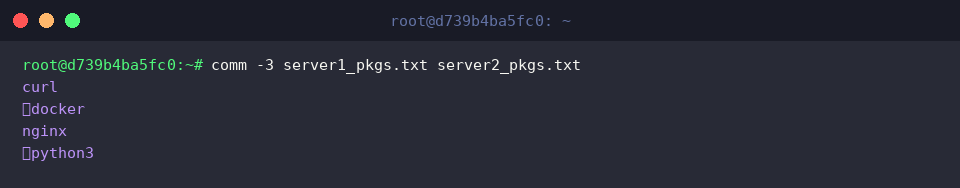
Al aplicar comm -3 server1_pkgs.txt server2_pkgs.txt, suprimimos de raíz la tercera columna para concentrarnos únicamente en las desviaciones mutuas de configuración.
La salida omite dependencias idénticas (git y vim) y resalta con nitidez las diferencias: curl y nginx instalados sólo en el servidor 1, frente a docker y python3 presentes exclusivamente en el nodo 2.
Otro escenario frecuente implica texto con mezcla de cajas altas y bajas; construimos un primer conjunto de prueba ejecutando printf "Apple\nBANANA\ncherry\n" > mixed_a.txt.
Complementamos la prueba con un fichero de términos homónimos pero tipografía invertida mediante printf "apple\nbanana\nCHERRY\n" > mixed_b.txt.
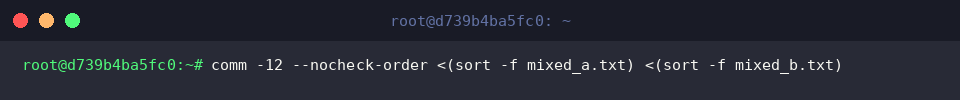
Al lanzar comm -12 --nocheck-order <(sort -f mixed_a.txt) <(sort -f mixed_b.txt), empleamos sort -f para forzar un ordenamiento insensible a mayúsculas/minúsculas y mitigamos bloqueos de consistencia con el modificador --nocheck-order.
Sin embargo, dado que comm realiza comparaciones binarias estrictas a nivel de byte, la disparidad en el código ASCII impide cualquier correspondencia literal exacta, derivando en una salida completamente vacía.
A lo largo de este laboratorio hemos dominado el funcionamiento de comm en Linux, desde el desglose estándar de discrepancias hasta el aislamiento selectivo de conjuntos de datos.
Dominar esta utilidad en conjunto con herramientas como sort y la redirección de procesos te brindará una ventaja técnica formidable para contrastar auditorías, logs voluminosos y despliegues de infraestructura con máxima velocidad.