


Introducción práctica
Cuando nos enfrentamos al análisis de registros extensos o volcados de texto masivos, surge la necesidad de fraccionarlos de manera inteligente según delimitadores semánticos o saltos de línea concretos. A diferencia de la utilidad convencional split (que únicamente fragmenta por volumen de bytes o cantidad fija de filas), la herramienta csplit ofrece un control quirúrgico guiado por expresiones regulares y patrones de contenido. En esta guía repasaremos su sintaxis operativa mediante ejercicios directos en consola.
Segmentación de archivos según números de línea específicos
Para arrancar con el laboratorio y mantener aislado nuestro entorno de pruebas, creamos una carpeta de trabajo y accedemos a ella ejecutando mkdir -p ~/csplit_lab && cd ~/csplit_lab.
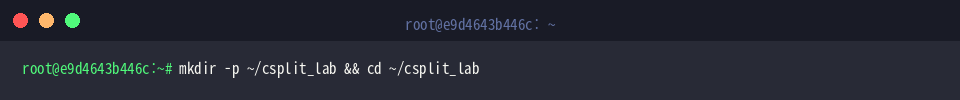
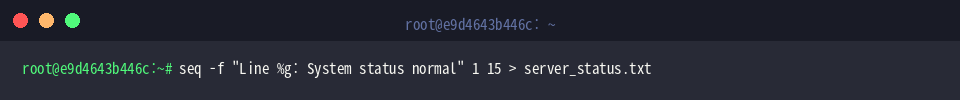
A continuación, preparamos un documento sintético de quince líneas que simule registros de estado del sistema mediante la orden seq -f "Line %g: System status normal" 1 15 > server_status.txt.
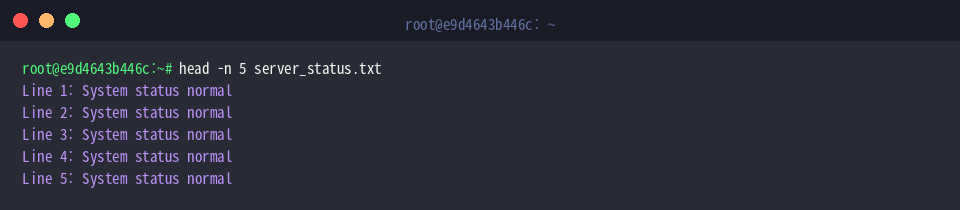
Inspeccionamos los primeros registros del fichero generado con head -n 5 server_status.txt para comprobar la estructura de las líneas de entrada.
La utilidad csplit se encarga de trocear archivos tomando como referencia números de fila o coincidencias basadas en patrones de búsqueda.
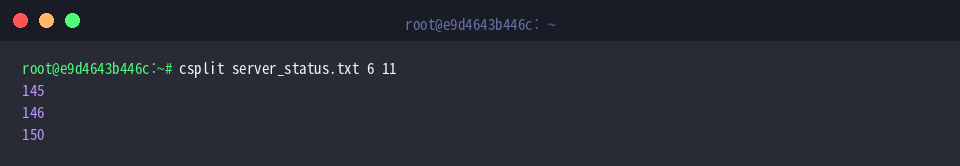
Al emitir csplit server_status.txt 6 11, le indicamos al intérprete que corte justo antes de las líneas 6 y 11. Esto segmenta el archivo de origen en tres porciones: filas 1 a 5, filas 6 a 10 y filas 11 a 15.
Los valores numéricos devueltos en la terminal tras la ejecución corresponden al tamaño exacto en bytes de cada pieza generada.
⚙️ [Parámetros destacados]
-f PREFIX : Sustituye el prefijo predeterminado (xx) del nombre de los archivos resultantes por la cadena indicada.-b FORMAT : Aplica un formato de numeración personalizado según las reglas de printf.-n DIGITS : Establece la cantidad de dígitos numéricos en el sufijo generado (el valor por omisión es 2).-s : Activa el modo silencioso, evitando imprimir en pantalla el conteo de bytes de los archivos creados.-z : Suprime y no crea ningún fragmento resultante cuyo tamaño sea de 0 bytes.-k : Conserva intactos los archivos ya generados si se produce algún error imprevisto durante el proceso.
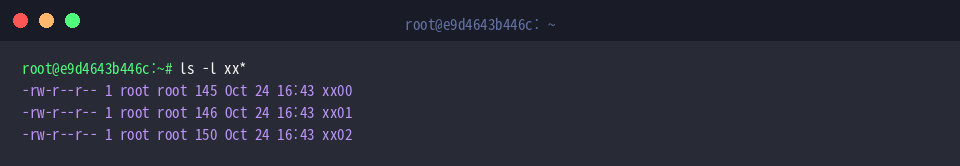
Verificamos el directorio para confirmar los ficheros creados corriendo ls -l xx*.
El sistema generó exitosamente los archivos xx00, xx01 y xx02, empleando la raíz predeterminada xx y reflejando las dimensiones de cada intervalo procesado.
Extracción y división automática mediante expresiones regulares
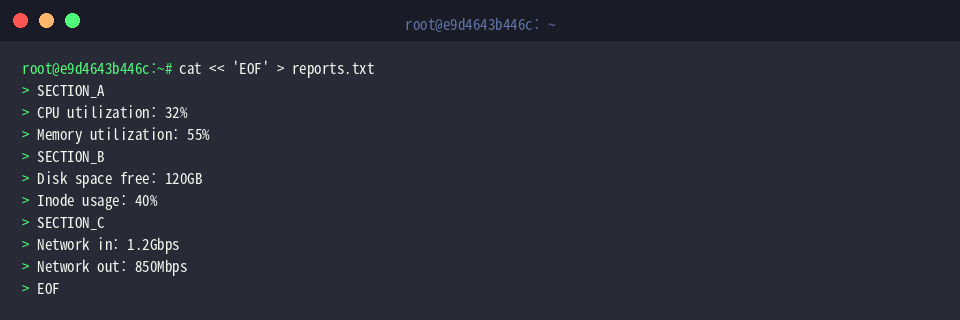
Para poner a prueba la partición basada en reglas de texto complejas, construimos un archivo con bloques métricos delimitados lanzando cat << 'EOF' > reports.txt.
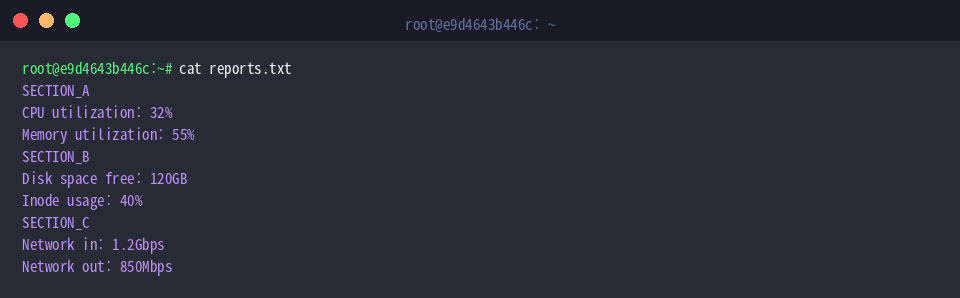
Visualizamos el contenido íntegro del reporte con cat reports.txt para asegurar que las secciones identificadas como SECTION_A, SECTION_B y SECTION_C quedaron correctamente estructuradas.
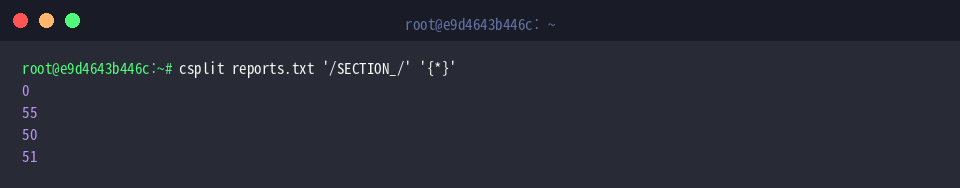
El comando csplit reports.txt '/SECTION_/' '{*}' busca de manera secuencial cada línea que cumpla con la regla /SECTION_/. La instrucción { * } actúa como un bucle repetidor que recorre el documento hasta el final, generando un nuevo fragmento con cada coincidencia.
La salida muestra el peso en bytes de los ficheros construidos; el primer número representa el bloque previo a la primera coincidencia (en este caso, 0 bytes al coincidir con la cabecera inicial).
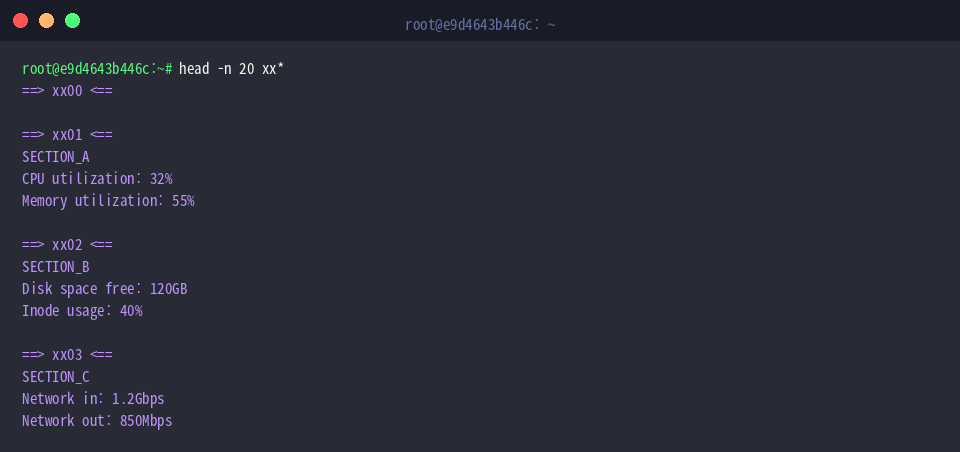
Comprobamos la distribución de los datos resultantes mediante head -n 20 xx*.
Se observa que el archivo vacío xx00 corresponde al prefacio anterior al primer encabezado, mientras que los bloques de métricas quedaron organizados secuencialmente en xx01, xx02 y xx03.
Personalización del prefijo y formato numérico de salida
A fin de ilustrar cómo modificar los nombres generados automáticamente, creamos un archivo de registro ficticio con cat << 'EOF' > app.log.
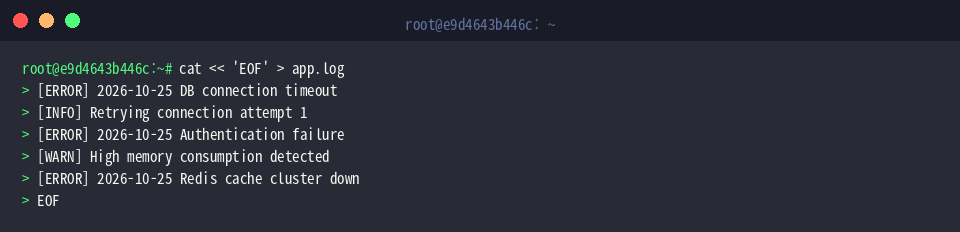
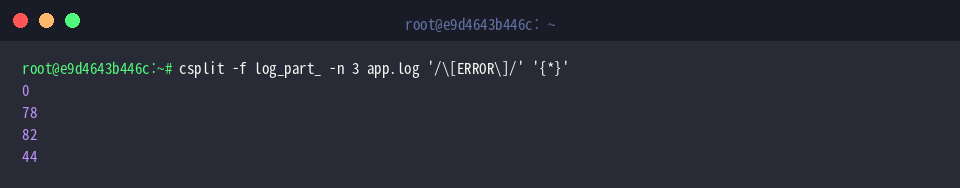
Para trocear cada incidente crítico con un formato ordenado, ejecutamos csplit -f log_part_ -n 3 app.log '/\[ERROR\]/' '{*}'. Esta orden fija el prefijo log_part_ con -f, formatea el sufijo numérico a tres posiciones mediante -n 3 y segmenta ante cada ocurrencia de la cadena [ERROR].
Nuevamente, el terminal lista la longitud en bytes de los componentes resultantes.
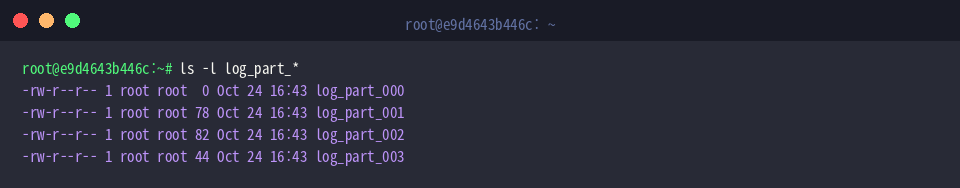
Listamos los detalles de los elementos generados mediante ls -l log_part_*.
Comprobamos que se aplicó el esquema configurado, obteniendo los archivos desde log_part_000 hasta log_part_003 con su numeración de tres cifras correlativas.
Ajustes avanzados de producción: descartar archivos vacíos (-z) y prevenir borrados (-k)
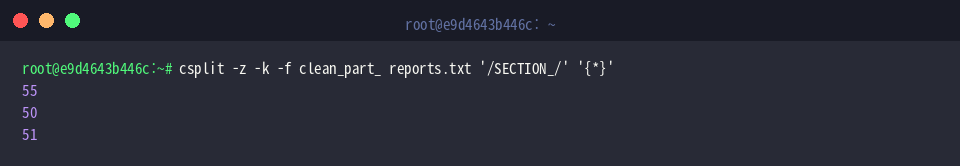
La combinación csplit -z -k -f clean_part_ reports.txt '/SECTION_/' '{*}' pone en juego dos opciones cruciales en scripts de automatización: -z descarta directamente la creación de cualquier fragmento de tamaño nulo, mientras que -k protege los datos ya procesados en caso de cancelaciones o errores a mitad del camino.
Al omitir el segmento inicial vacío, la salida solo reporta los tres bloques legítimos con información (55, 50 y 51 bytes respectivamente).
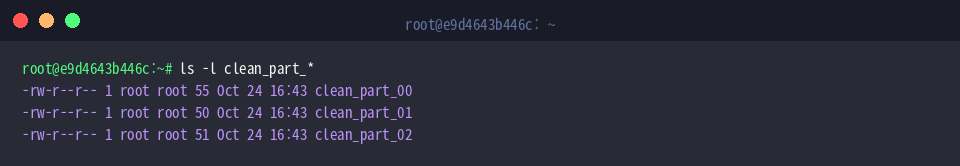
Revisamos el directorio con ls -l clean_part_* para validar el resultado.
Gracias al modificador -z, nos libramos del archivo residual inicial y obtenemos únicamente tres ficheros limpios: clean_part_00, clean_part_01 y clean_part_02.
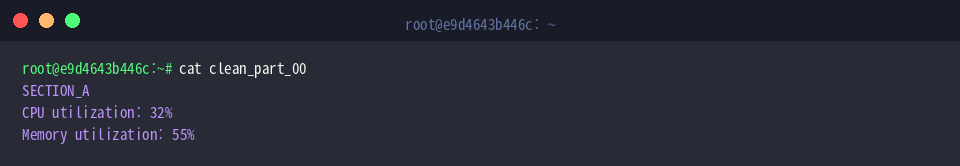
Confirmamos la integridad del primer archivo abriéndolo con cat clean_part_00.
El contenido arranca directamente en el encabezado SECTION_A sin perder ni duplicar ninguna línea.
Una vez concluidas las verificaciones prácticas, limpiamos el directorio temporal ejecutando rm -rf ~/csplit_lab.
A lo largo de este tutorial hemos explorado cómo el comando csplit supera con creces las limitaciones del particionado básico por tamaño en entornos Linux. Ya sea para aislar trazas de fallos en logs continuos o para estructurar reportes multisección, su capacidad de interpretar expresiones regulares lo convierte en un recurso indispensable para la administración de sistemas.