


Présentation
Sous Linux, awk est l’outil le plus puissant pour traiter et filtrer efficacement des fichiers texte volumineux ou des données de logs. Découvrez la syntaxe essentielle et les cas d’usage pratiques qui permettent d’extraire des colonnes spécifiques, d’effectuer des filtrages conditionnels et de calculer des totaux à l’aide d’une seule ligne de commande, sans devoir écrire de scripts complexes.
1. Fonctionnement de base d’awk et extraction de colonnes spécifiques
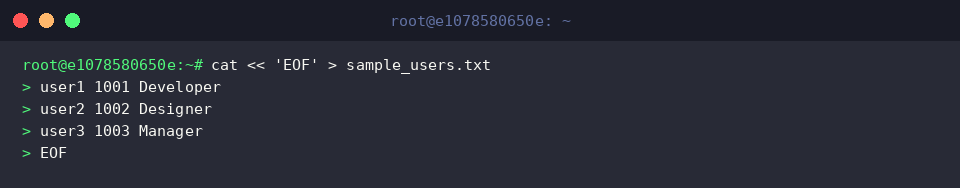
Pour pratiquer la commande awk, créons un fichier texte d’exemple contenant des noms d’utilisateurs, des identifiants et des fonctions professionnelles séparés par des espaces.
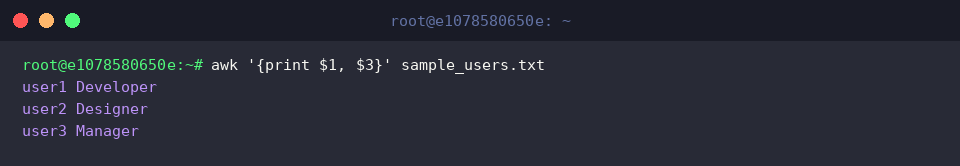
À l’aide de la commande awk, extrayez et affichez sur chaque ligne le premier champ ($1, le nom d’utilisateur) et le troisième champ ($3, la fonction), avec l’espace comme séparateur.
Par défaut, si aucun séparateur spécifique n’est défini, awk découpe les champs en se basant sur les espaces ou les tabulations consécutifs.
⚙️ [Options principales]
-F fs : Définit le séparateur de champs d’entrée (Field Separator).-v var=val : Attribue une valeur initiale à une variable utilisable dans le script awk avant son exécution.-f progfile : Spécifie le chemin du fichier contenant le code du script awk à exécuter.
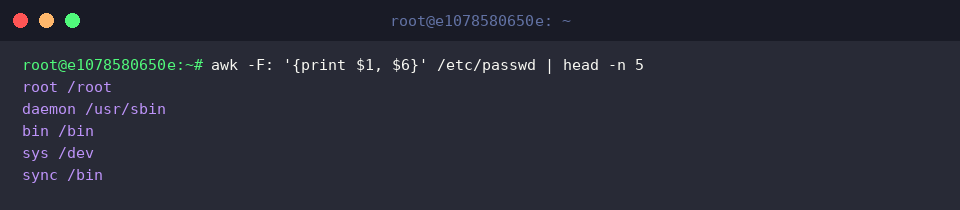
Dans le fichier /etc/passwd délimité par des deux-points (:), définissez le séparateur à l’aide de l’option -F:, puis extrayez uniquement le premier champ ($1, le nom de compte) et le sixième champ ($6, le chemin du répertoire personnel) pour vérifier les 5 premières lignes.
2. Filtrage personnalisé des données avec conditions et opérateurs
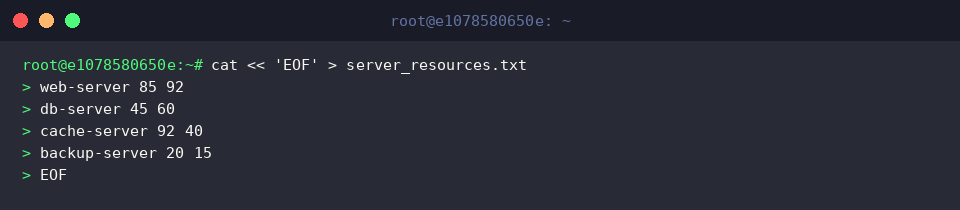
Créons un fichier d’exercice server_resources.txt contenant les taux d’utilisation du CPU et de la mémoire par serveur.
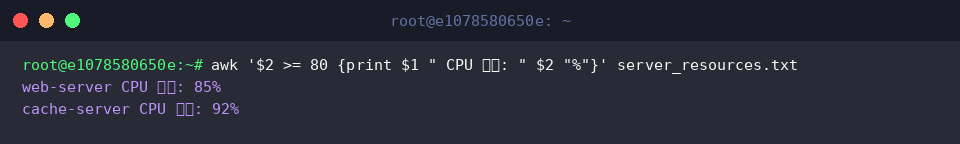
Grâce à une expression conditionnelle, sélectionnez les lignes où le second champ ($2, le taux d’utilisation CPU) est supérieur ou égal à 80 %, puis affichez le nom du serveur correspondant ainsi qu’un message d’alerte.
Cette approche est particulièrement utile pour identifier les ressources système qui dépassent un seuil critique.
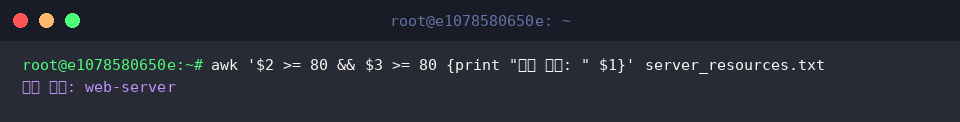
À l’aide de l’opérateur logique ET (&&), identifiez et affichez les serveurs à risque dont les taux d’utilisation du CPU ($2) et de la mémoire ($3) sont tous deux supérieurs ou égaux à 80 %.
L’application de conditions combinées permet d’isoler uniquement les cibles dont plusieurs ressources franchissent simultanément le seuil d’alerte.
3. Statistiques et calculs de totaux avec variables intégrées et blocs BEGIN/END
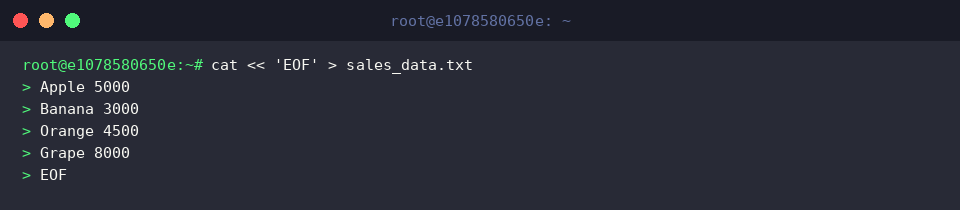
Pour effectuer des exercices d’agrégation de données et de statistiques avec awk, créons un fichier d’exemple sales_data.txt contenant les articles et leurs chiffres de vente.
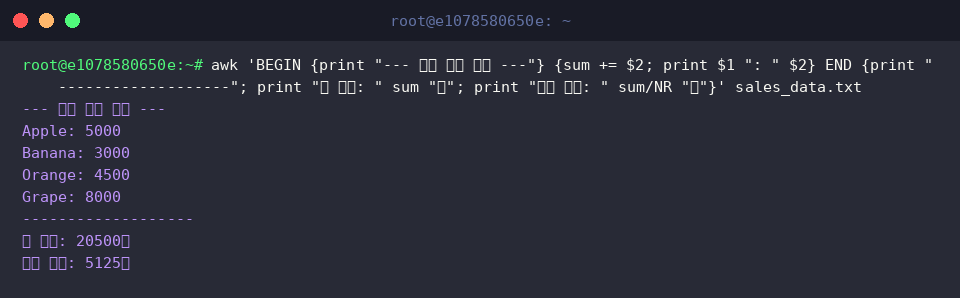
Le bloc BEGIN affiche un message initial avant le traitement du corps du fichier, puis accumule la valeur du deuxième champ ($2) de chaque ligne dans la variable sum.
Le bloc END, exécuté après le traitement de toutes les lignes, calcule et affiche le total des ventes ainsi que la moyenne à l’aide de la variable intégrée NR (nombre total d’enregistrements).
4. Analyse de logs de serveur web en conditions réelles et filtrage de trafic anormal
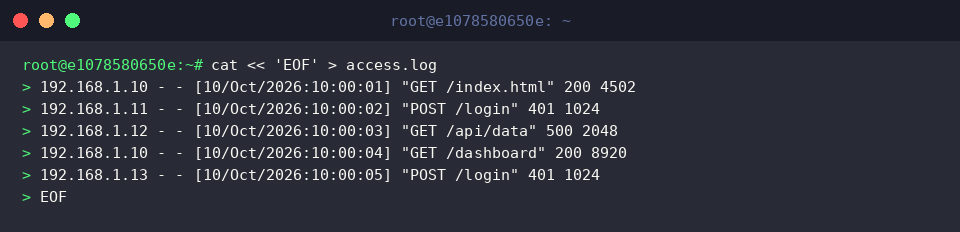
Pour s’exercer à l’analyse de logs de serveur web et au suivi des erreurs, créons un fichier journal d’exemple access.log au format standard Nginx et Apache.
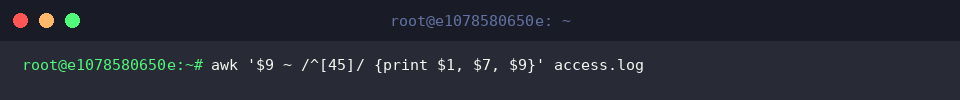
Utilisez l’opérateur de correspondance d’expression régulière (~) pour filtrer les lignes correspondant aux erreurs client 4xx et aux erreurs serveur 5xx, où le neuvième champ ($9, le code de statut HTTP) commence par 4 ou 5.
En extrayant uniquement l’adresse IP cliente ($1), l’URI requise ($7) et le code d’état ($9) des logs correspondants, vous pouvez rapidement évaluer les incidents et l’apparition de trafic anormal.
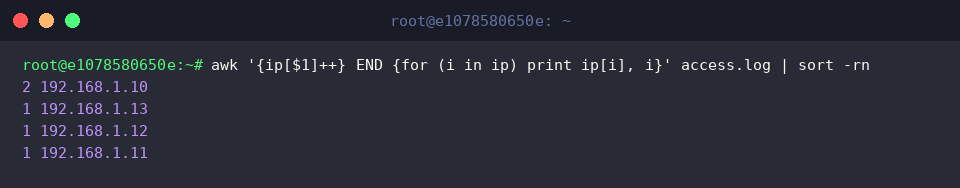
Grâce aux tableaux associatifs de awk (ip[$1]++), comptez le nombre de requêtes par IP source, affichez le cumul global via une boucle dans le bloc END, puis triez par fréquence décroissante à l’aide d’un pipeline vers sort -rn.
Il s’agit d’une technique d’analyse concrète très efficace pour détecter un trafic excessif provenant d’une adresse IP spécifique ou des tentatives d’accès anormales.
Nous venons de passer en revue la syntaxe fondamentale ainsi que les exemples pratiques indispensables de la commande awk, qui simplifie grandement le traitement de texte et l’analyse de gros volumes de logs sous Linux.
N’hésitez pas à intégrer dès aujourd’hui les différentes options et motifs abordés dans vos tâches quotidiennes pour automatiser et optimiser vos opérations répétitives d’extraction et de traitement de données.