


Présentation
Les anomalies d’affichage dues à un mauvais jeu de caractères représentent un écueil classique lors de l’exploitation de journaux ou de scripts sous Linux. Pour restaurer l’intégrité d’un document illisible, diagnostiquer son encodage exact constitue le préalable incontournable. Ce tutoriel détaille le déploiement de l’utilitaire chardetect, son usage sur des flux réels ainsi que son mécanisme d’analyse heuristique associé à iconv.
Déploiement du paquet chardetect et options courantes
L’intégration de l’outil s’effectue via le gestionnaire APT en mettant à jour le cache local puis en installant le paquet python3-chardet.
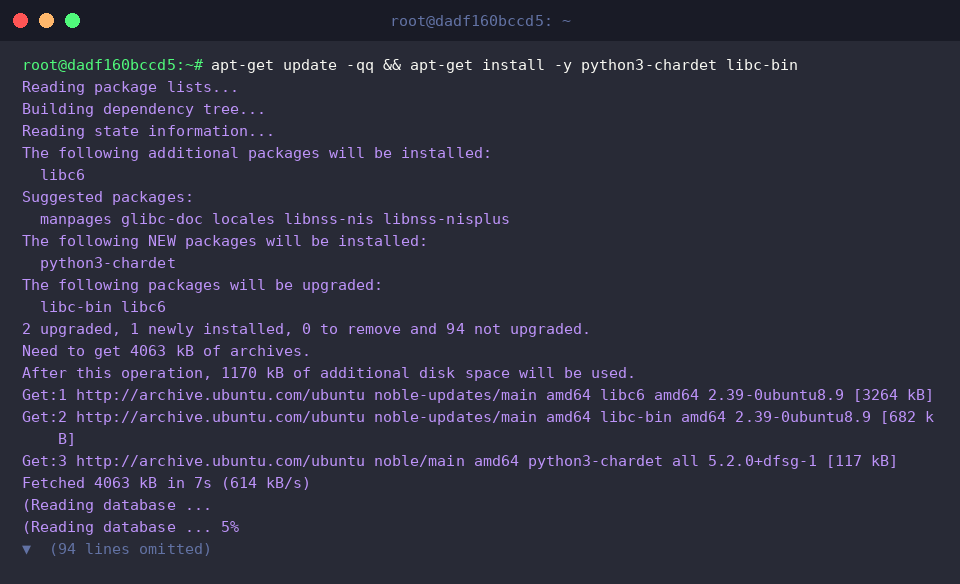
Le binaire chardetect inspecte un fichier brut ou un flux entrant pour déterminer le charset le plus probable, tout en lui associant un indice de certitude statistique.
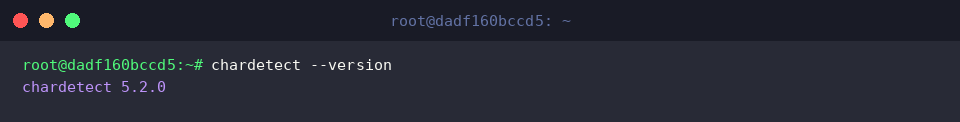
L’indicateur --version permet de contrôler la version déployée au sein de l’environnement.
⚙️ [Paramètres principaux]
-l, --line-per-line : déclenche une analyse distincte ligne par ligne plutôt qu’une évaluation globale du flux.--minimal : restreint le résultat au seul nom de l’encodage détecté, omettant le score probabiliste.-h, --help : affiche la documentation synthétique des arguments acceptés.--version : retourne les métadonnées de version du programme avant de quitter.
Création de fichiers tests et validation des encodages
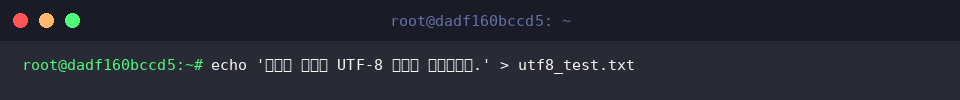
Pour illustrer le comportement de l’analyseur sur des encodages hétérogènes, nous initialisons d’abord un fichier de référence au format standard UTF-8 nommé utf8_test.txt avec la commande echo.
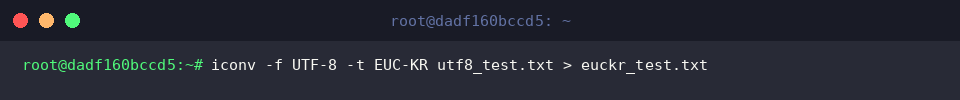
Afin d’obtenir un jeu de données alternatif, l’utilitaire iconv convertit ce contenu d’origine vers l’encodage coréen historique EUC-KR, enregistré sous le nom euckr_test.txt.
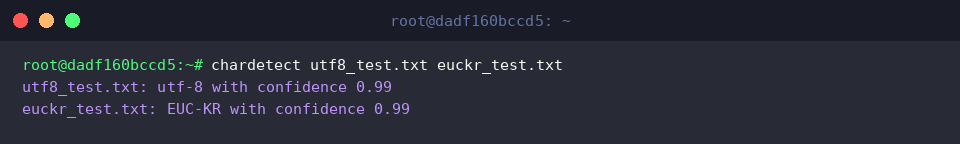
L’exécution conjointe de chardetect sur ces deux cibles met en lumière ses capacités d’évaluation : chaque document fait l’objet d’un rapport mentionnant son jeu de caractères et le taux de certitude correspondant.
Le résultat confirme sans ambiguïté la nature de utf8_test.txt (UTF-8) et de euckr_test.txt (EUC-KR), chacune affichant un indice de fiabilité de 99 %.
Traitement via redirection de flux et balayage massif
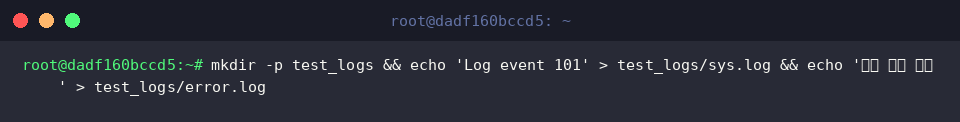
Pour simuler des conditions proches de la production, un répertoire dédié test_logs est créé pour accueillir deux fichiers de journalisation distincts via l’instruction combinée mkdir -p test_logs && echo 'Log event 101' > test_logs/sys.log && echo '서버 에러 로그' > test_logs/error.log.
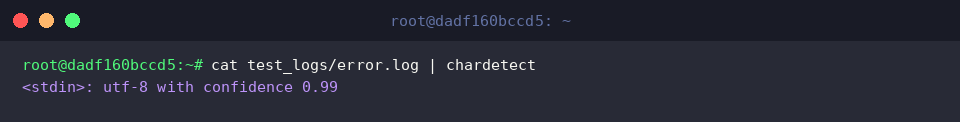
Grâce au mécanisme de tube (|), le contenu du fichier peut être directement injecté dans l’entrée standard de chardetect.
L’analyseur signale alors l’origine comme <stdin> et identifie instantanément l’encodage UTF-8 avec une confiance de 99 %.
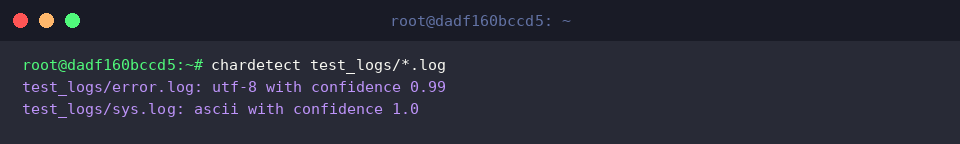
Pour auditer simultanément plusieurs dizaines de traces, l’usage d’un filtre générique (*) facilite le traitement par lots sur l’ensemble de l’arborescence test_logs.
Le moteur catégorise parfaitement error.log en UTF-8 en raison de ses glyphes multilingues, tout en classant sys.log, exclusivement composé de caractères latins standards, sous l’encodage minimal ASCII.
Moteur sous-jacent et conversion ciblée avec iconv
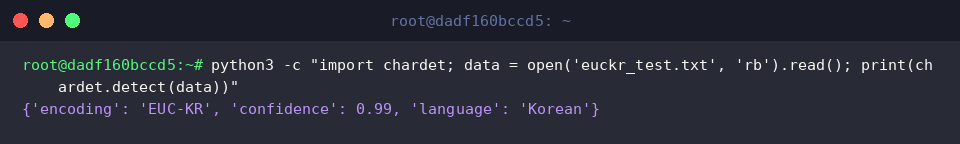
Le fonctionnement interne de l’utilitaire repose sur la bibliothèque Python sous-jacente chardet. Une invocation directe en ligne de commande permet de scruter les métadonnées brutes issues du flux d’octets.
Cette inspection programmatique renvoie un dictionnaire structuré précisant l’encodage (EUC-KR), le score de confiance statistique (0.99) et la famille linguistique associée (Korean).
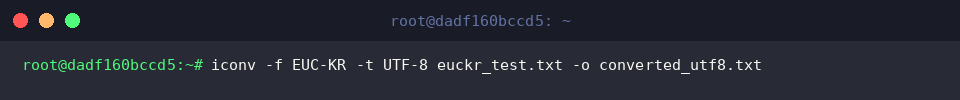
Dès lors que l’encodage initial est validé, iconv permet d’opérer la normalisation du fichier euckr_test.txt vers un format universel sous le libellé converted_utf8.txt.
Le paramètre -f EUC-KR spécifie le format d’entrée alors que -t UTF-8 définit la cible, garantissant un transcodage sans altération de caractères.
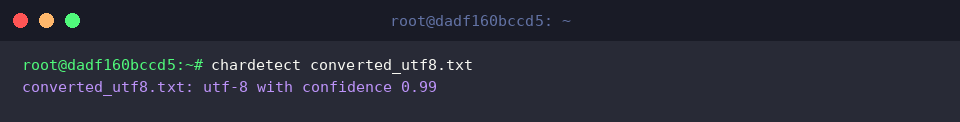
Un audit final sur converted_utf8.txt au moyen de chardetect sert de validation technique finale.
Le rapport atteste du succès de l’opération en confirmant que la structure du fichier répond désormais au standard UTF-8 avec une certitude absolue de 99 %.
Vous disposez dorénavant d’un flux de travail complet et robuste pour diagnostiquer les corruptions de texte sous Linux et rétablir des encodages fiables à l’aide du tandem chardetect et iconv.