


Introduction et principes fondamentaux
Lors du traitement de volumineux journaux d’activité ou de fichiers texte structurés, l’utilitaire traditionnel split montre vite ses limites dès qu’une fragmentation sémantique s’impose. La commande csplit (Context Split) comble précisément ce besoin en isolant des segments de données selon des repères de lignes ou des motifs rationnels (expressions régulières). Découvrons ensemble comment exploiter toute la puissance de cet outil d’administration système à travers des cas d’usage concrets.
Segmentation élémentaire selon les numéros de ligne
Avant d’aborder les manipulations, préparons un bac à sable isolé au sein du système de fichiers en exécutant mkdir -p ~/csplit_lab && cd ~/csplit_lab.
Afin d’alimenter nos premiers tests, nous générons un jeu de données textuel linéaire composé de 15 lignes de statut via seq -f "Line %g: System status normal" 1 15 > server_status.txt.
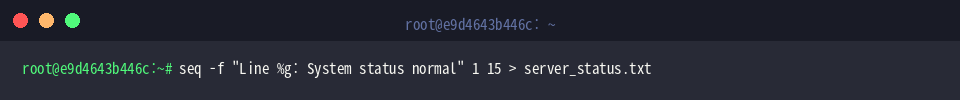
Un rapide coup d’œil aux cinq premières entrées du fichier source permet de valider le format produit : head -n 5 server_status.txt.
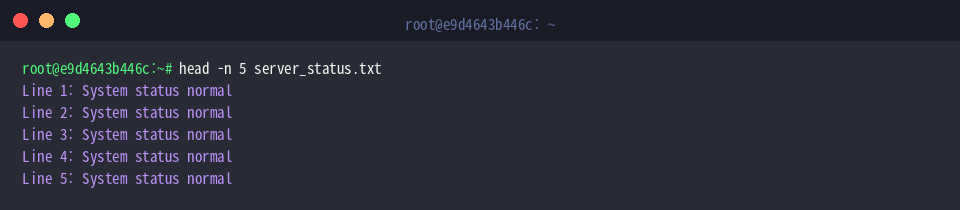
Le mécanisme central de csplit repose sur la définition de points de rupture statiques ou dynamiques.
En lançant csplit server_status.txt 6 11, l’utilitaire segmente le fichier source aux seuils indiqués, produisant ainsi trois sous-ensembles distincts (lignes 1 à 5, lignes 6 à 10 et lignes 11 à 15).
Les valeurs numériques renvoyées en sortie standard correspondent au volume d’octets composant chaque partition générée.
⚙️ [Paramètres essentiels]
-f PREFIX : Substitue le préfixe générique (xx) par la chaîne de votre choix.-b FORMAT : Définit la structure d’incrémentation numérique selon la syntaxe de printf.-n DIGITS : Fixe le nombre de chiffres du compteur en suffixe (par défaut : 2).-s : Active le mode silencieux en masquant le rapport de taille en octets.-z : Écarte systématiquement tout fichier de sortie vide mesurant 0 octet.-k : Préserve l’intégrité des fichiers déjà extraits en cas d’interruption ou d’erreur pendant le traitement.
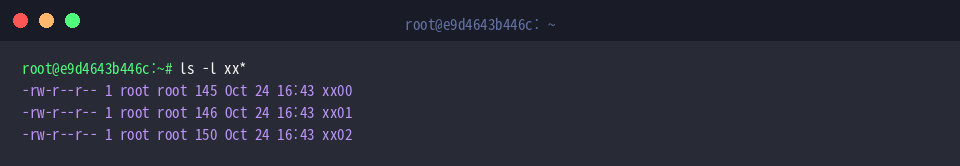
L’inventaire du répertoire courant s’effectue via ls -l xx*.
On constate la présence effective des segments xx00, xx01 et xx02, nommés d’après la convention native et reflétant exactement les tranches de lignes ciblées.
Découpage contextuel par expressions régulières
Pour illustrer le partitionnement contextuel, nous assemblons un document hétérogène divisé en plusieurs blocs fonctionnels à l’aide de l’instruction cat << 'EOF' > reports.txt.
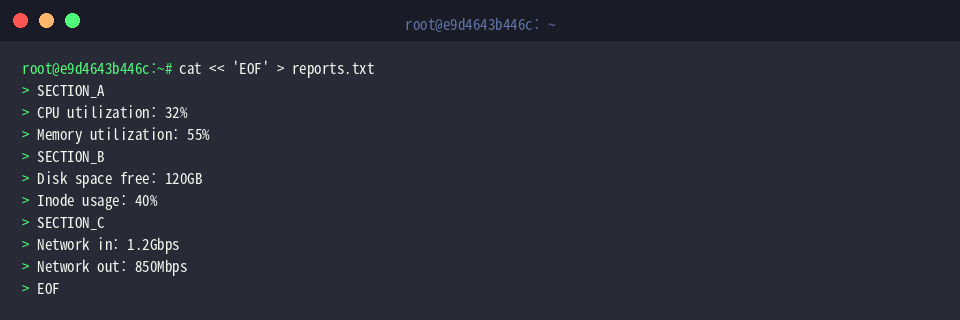
L’affichage de l’intégralité du document d’audit système s’obtient via cat reports.txt.
Les métriques système apparaissent bien regroupées sous les délimiteurs SECTION_A, SECTION_B et SECTION_C.
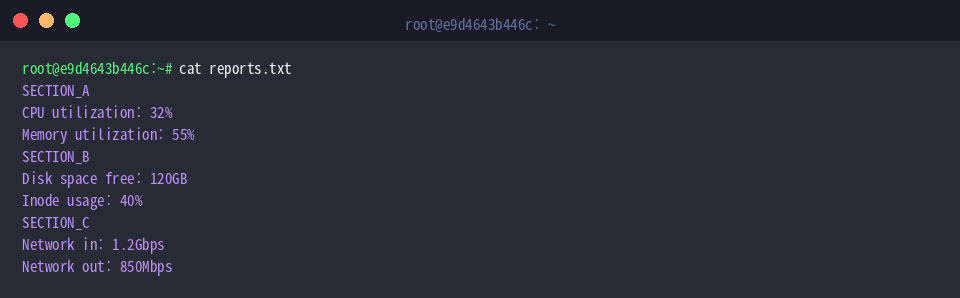
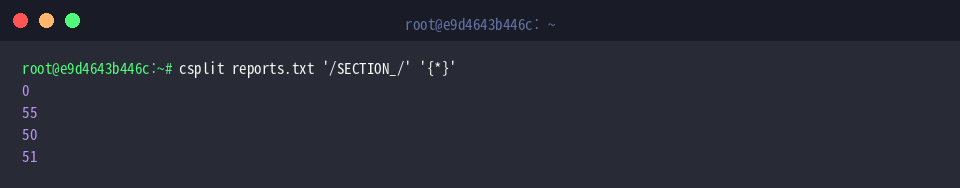
La commande csplit reports.txt '/SECTION_/' '{*}' scrute le document et opère une scission à chaque occurrence du motif /SECTION_/, le qualificateur { * } indiquant au moteur de poursuivre l’extraction jusqu’au terme du flux textuel.
Les entiers retournés dans le terminal reflètent la taille en octets de chaque composant extrait, incluant le fragment préalable (ici vide, mesurant 0 octet) précédant la première occurrence du motif.
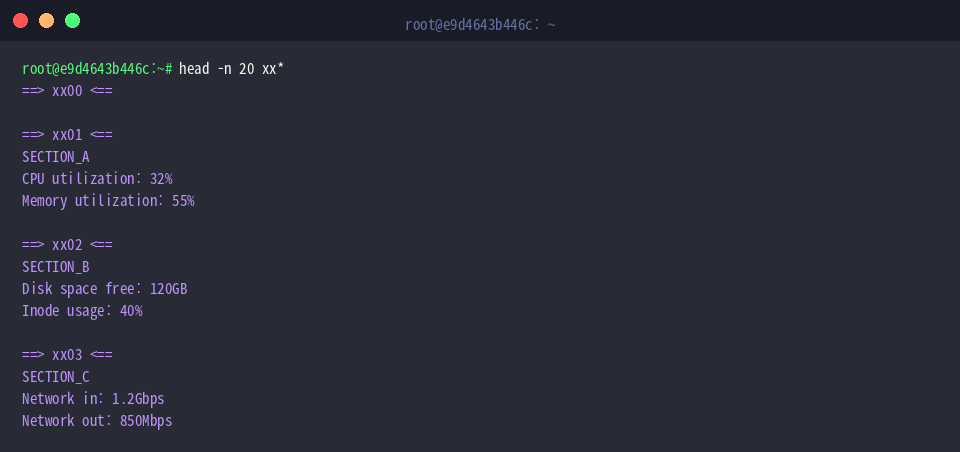
Examinons la distribution des données extraites grâce à la commande head -n 20 xx*.
À l’exception du premier segment xx00 représentant l’en-tête vide avant la première balise, chaque bloc de métriques est parfaitement isolé au sein des unités xx01, xx02 et xx03.
Personnalisation des préfixes et du formatage numérique
Pour configurer une nomenclature adaptée aux environnements de production, nous simulons un fichier journal d’application via cat << 'EOF' > app.log.
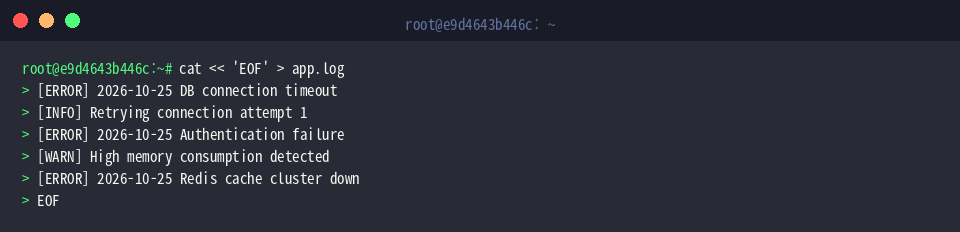
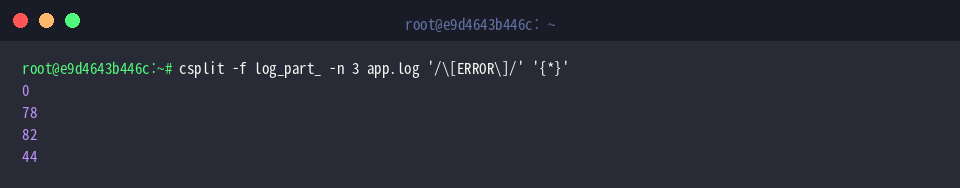
L’instruction csplit -f log_part_ -n 3 app.log '/\[ERROR\]/' '{*}' isole chaque événement critique sur la base de la chaîne [ERROR], tout en assignant le préfixe personnalisé -f log_part_ et une indexation à trois chiffres -n 3.
La sortie console restitue fidèlement la dimension en octets de chaque segment isolé.
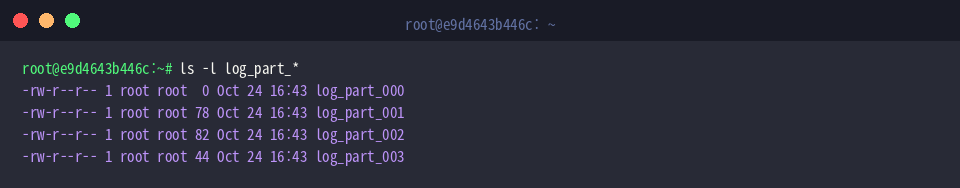
La consultation détaillée des artefacts créés est vérifiée par ls -l log_part_*.
Les fichiers adoptent sans ambiguïté la structure demandée, allant de log_part_000 à log_part_003.
Optimisation en production : gestion des erreurs (-k) et suppression des fichiers vides (-z)
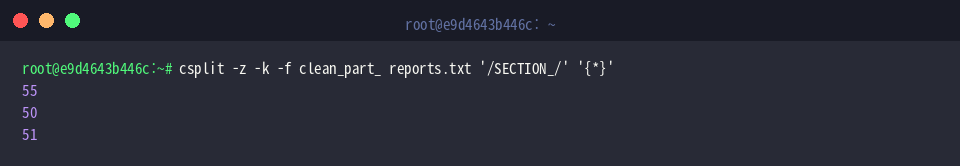
La commande csplit -z -k -f clean_part_ reports.txt '/SECTION_/' '{*}' conjugue l’indicateur -z, qui supprime d’office les fragments résiduels sans contenu (0 octet), et l’option -k, qui sécurise les étapes franchies en conservant les fragments créés même si un dysfonctionnement survient.
Le segment nul initial ayant été ignoré, la sortie affiche uniquement le volume des trois sous-ensembles de données réelles (55, 50 et 51 octets).
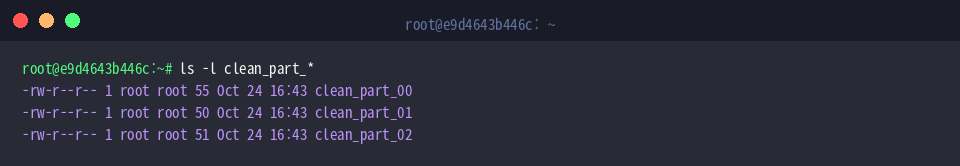
Confirmons la propreté du résultat avec ls -l clean_part_*.
Grâce au filtre -z, aucun fichier inutile n’a été créé : seules les trois partitions opérationnelles clean_part_00, clean_part_01 et clean_part_02 figurent sur le disque.
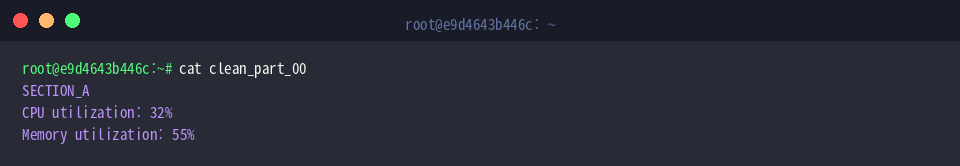
Pour nous assurer que la partition initiale contient bien le premier bloc opérationnel, lançons cat clean_part_00.
Le contenu démarre directement sur les mesures de SECTION_A, démontrant une extraction rigoureuse exempte de décalage.
Pour finaliser notre session d’apprentissage, libérons les ressources allouées en supprimant l’arborescence temporaire : rm -rf ~/csplit_lab.
Vous disposez désormais d’une maîtrise complète de la commande csplit, un outil indispensable pour l’analyse de gros volumes de logs et l’automatisation de vos flux de données textuels sous Linux.