


Présentation générale
L’utilitaire cut constitue un rouage fondamental de la boîte à outils GNU/Linux pour quiconque manipule des journaux applicatifs ou des flux textuels structurés. Ce tutoriel pratique sous Ubuntu détaille les fonctionnalités maîtresses de cet outil, de l’isolation de colonnes par délimiteur au découpage précis par position de caractères ou d’octets.
Préparation de l’environnement de test et des jeux d’essai
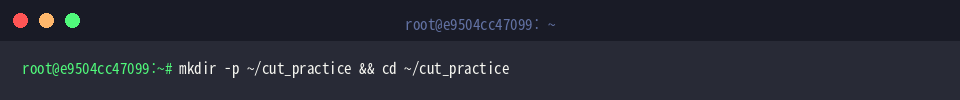
Afin d’isoler nos expérimentations sans risquer d’altérer vos fichiers courants, initialisons un répertoire de travail dédié puis basculons à l’intérieur via la commande mkdir -p ~/cut_practice && cd ~/cut_practice.
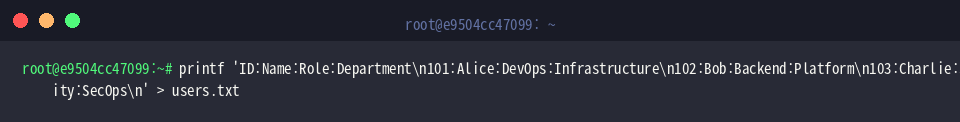
Générons d’abord un fichier users.txt simulant une base d’utilisateurs où chaque champ technique est séparé par un deux-points (:) à l’aide de l’instruction printf.
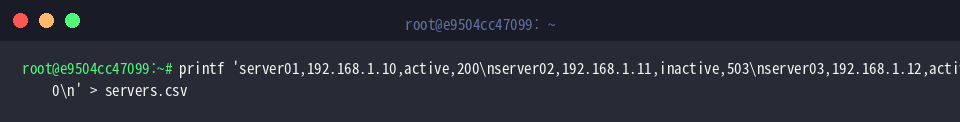
Créons ensuite servers.csv, un inventaire de machines au format CSV classique séparé par des virgules (,) indiquant adresses IP et statuts de service.
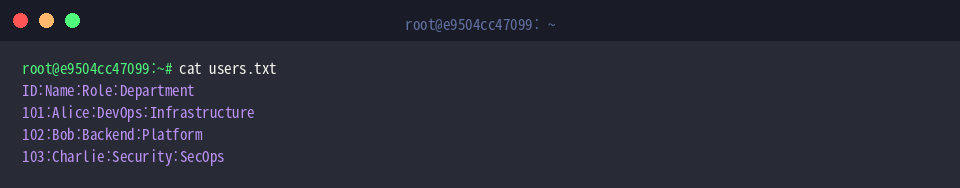
Vérifions la structure et l’intégrité de notre premier jeu de données en exécutant cat users.txt.
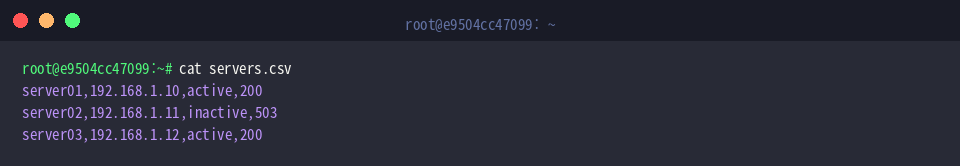
Assurons-nous également du bon agencement des enregistrements du fichier servers.csv avant d’entamer les extractions avec cat servers.csv.
Extraction ciblée de colonnes via les options -d et -f
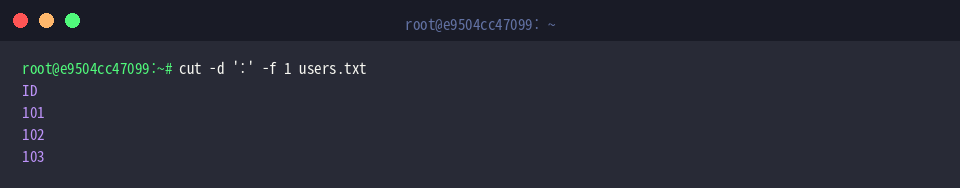
Pour isoler uniquement les identifiants techniques dans users.txt, nous déclarons le deux-points comme séparateur avec -d ':' et sélectionnons la première position grâce au commutateur -f 1 via cut -d ':' -f 1 users.txt.
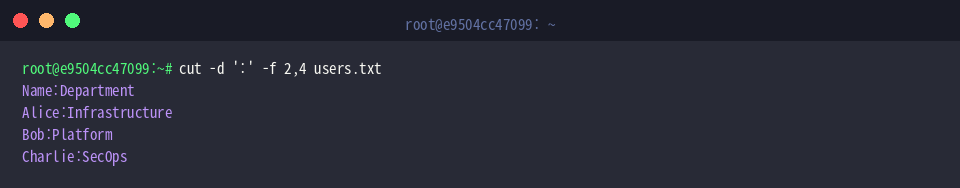
Il est tout à fait possible de cibler plusieurs colonnes disjointes en séparant leurs index par une virgule. La commande cut -d ':' -f 2,4 users.txt retient conjointement le nom (colonne 2) et le département (colonne 4).
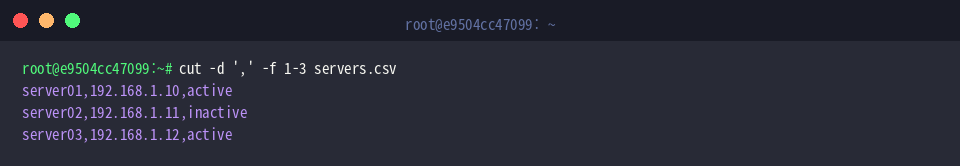
Pour capturer une plage continue de champs, le trait d’union sert d’intervalle. Appliquée à servers.csv avec la virgule comme délimiteur, la syntaxe cut -d ',' -f 1-3 servers.csv rassemble les colonnes 1 à 3 (nom d’hôte, IP et état d’activité).
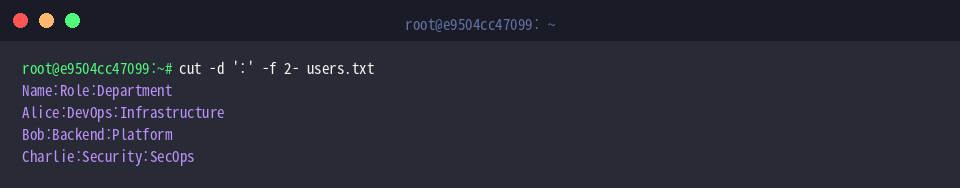
Lorsque l’on souhaite exclure une clé primaire située au début de ligne et récupérer l’intégralité du reste de l’enregistrement jusqu’au bout, la notation ouverte cut -d ':' -f 2- users.txt remplit parfaitement cet office.
Découpage à largeur fixe par caractères (-c) et octets (-b)
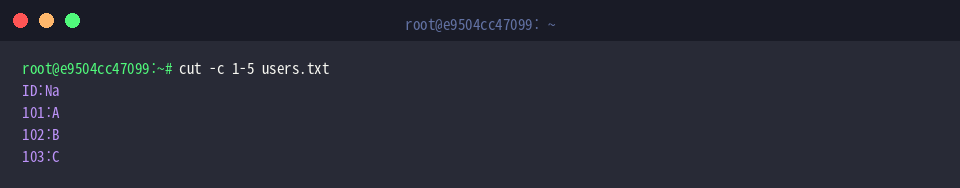
Face à des formats textuels à colonnes fixes dépourvus de séparateurs explicites, l’option -c extrait des segments de texte positionnels. La commande cut -c 1-5 users.txt prélève les cinq premiers caractères de chaque ligne.
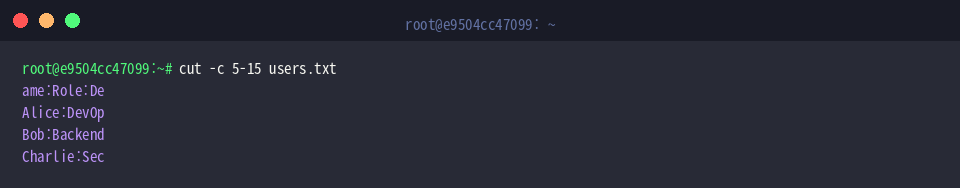
Le même principe s’applique à un segment médian : l’argument cut -c 5-15 users.txt capture avec précision la portion de chaîne s’étendant du cinquième au quinzième caractère.
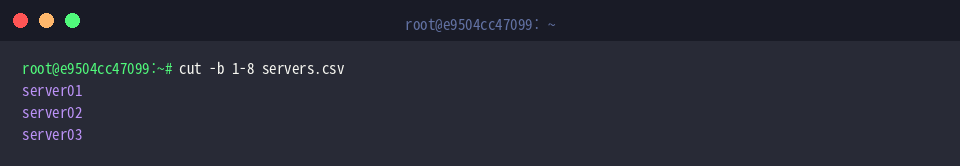
Lorsque l’on travaille directement sur l’empreinte binaire des flux bruts ou sur des encodages spécifiques, le paramètre -b opère au niveau de l’octet. L’instruction cut -b 1-8 servers.csv tronque les lignes pour n’en conserver que les 8 premiers octets.
Options avancées : reformatage de sortie et inversion (–complement)
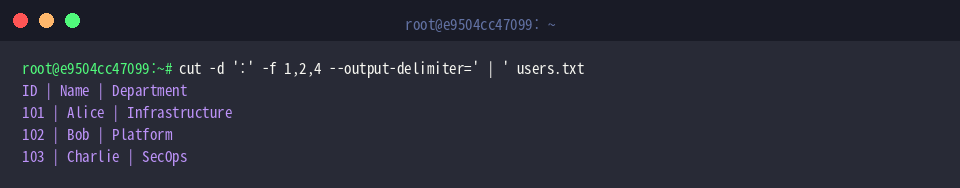
Par défaut, cut restitue les colonnes en réutilisant le séparateur d’origine. L’argument --output-delimiter permet de substituer ce symbole (par exemple par un tube encadré d’espaces) pour rendre la sortie bien plus lisible à l’écran via cut -d ':' -f 1,2,4 --output-delimiter=' | ' users.txt.
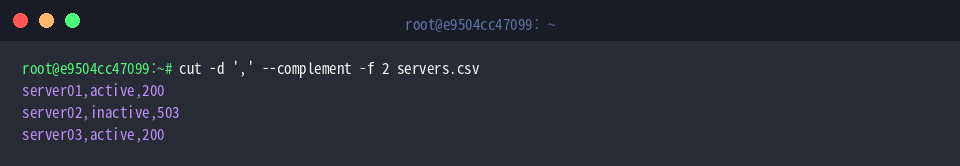
Au lieu d’énumérer toutes les colonnes à préserver, le flag --complement inverse la sélection. En exécutant cut -d ',' --complement -f 2 servers.csv, nous éliminons l’adresse IP tout en conservant automatiquement les champs 1, 3 et 4.
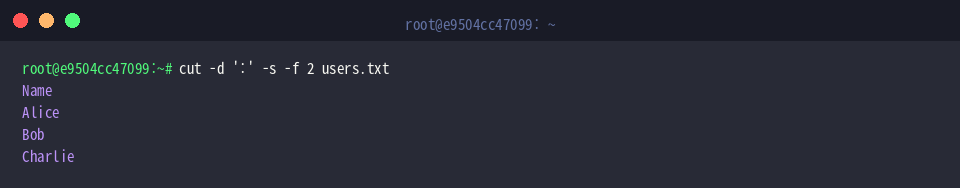
Pour immuniser vos scripts contre les lignes parasites ou malformées dépourvues du séparateur requis, le modificateur -s (--only-delimited) ignore silencieusement les enregistrements non conformes grâce à cut -d ':' -s -f 2 users.txt.
La commande cut demeure un incontournable sous Linux pour effectuer des opérations de filtrage rapides et performantes. En combinant judicieusement ses options au sein de vos pipelines Bash, vous optimiserez considérablement l’analyse de vos fichiers journaux et l’automatisation de vos tâches d’administration système.