


परिचय: टूटे हुए टेक्स्ट और एन्कोडिंग की समस्या
सर्वर एडमिनिस्ट्रेशन या सॉफ्टवेयर डेवलपमेंट के दौरान अक्सर ऐसे लॉग या टेक्स्ट दस्तावेज़ सामने आते हैं, जिनके कैरेक्टर सही ढंग से रेंडर नहीं होते और अजीबोगरीब प्रतीकों (gibberish/mojibake) में बदल जाते हैं। ऐसी स्थिति में समाधान खोजने से पहले फ़ाइल के वास्तविक कैरेक्टर सेट की सटीक पहचान करना आवश्यक हो जाता है। इस गाइड में हम जानेंगे कि chardetect यूटिलिटी का उपयोग करके अलग-अलग फ़ाइलों की एन्कोडिंग कैसे जांची जाती है, यह टूल पर्दे के पीछे कैसे काम करता है और iconv की मदद से गलत एन्कोडिंग को कैसे सुधारा जाता है।
chardetect टूल की स्थापना और पर्यावरण सेटअप
कमांड-लाइन पर इस विश्लेषण टूल को चलाने के लिए सबसे पहले सिस्टम की पैकेज रिपॉजिटरी अपडेट करके python3-chardet पैकेज इंस्टॉल करना होगा:
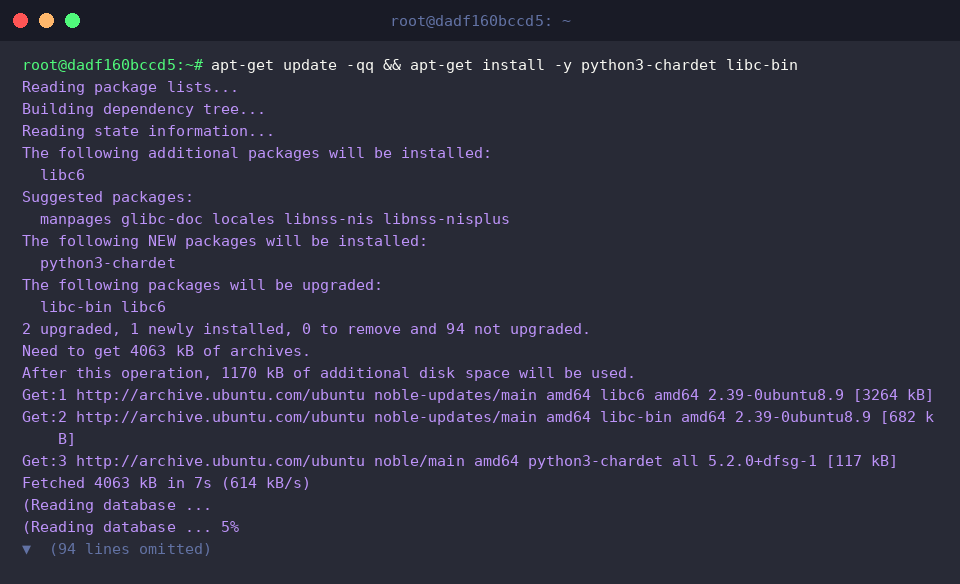
यह chardetect यूटिलिटी इनपुट स्ट्रीम या दी गई फ़ाइलों के बाइट पैटर्न की पड़ताल करती है और कैरेक्टर एन्कोडिंग (Charset) के साथ-साथ अपनी विश्वसनीयता दर (Confidence Score) भी दर्शाती है।
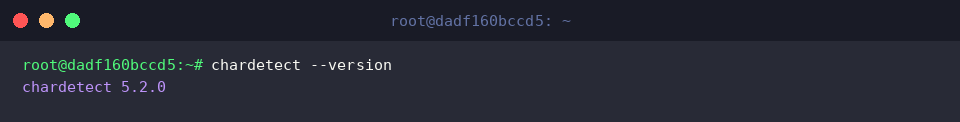
वर्तमान में स्थापित पैकेज का संस्करण जांचने के लिए --version फ्लैग का उपयोग किया जाता है।
⚙️ [उपयोगी कमांड विकल्प]
-l, --line-per-line : पूरी फ़ाइल के बजाय प्रत्येक पंक्ति का अलग-अलग एन्कोडिंग विश्लेषण करता है।--minimal : स्कोर और अतिरिक्त विवरण छुपाकर केवल एन्कोडिंग का नाम प्रदर्शित करता है।-h, --help : सहायता मेनू और सभी समर्थित विकल्पों की सूची खोलता है।--version : टूल के मौजूदा वर्जन की जानकारी देकर कमांड समाप्त करता है।
विभिन्न एन्कोडिंग प्रारूपों के साथ व्यावहारिक परीक्षण
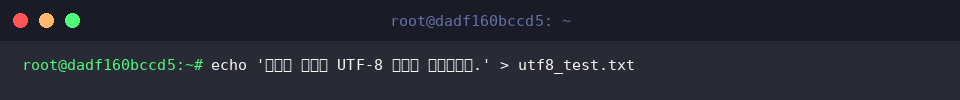
जांच की प्रक्रिया को समझने के लिए सबसे पहले मानक UTF-8 फॉर्मेट में echo कमांड के जरिए utf8_test.txt नामक डमी फ़ाइल तैयार करते हैं।
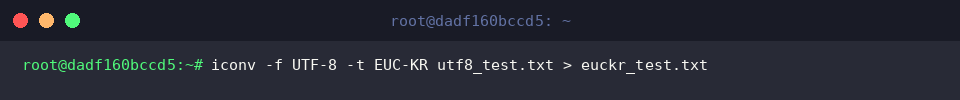
तुलनात्मक अध्ययन के उद्देश्य से, हम iconv टूल की मदद से इसी टेक्स्ट को EUC-KR एन्कोडिंग में कनवर्ट करके एक दूसरी फ़ाइल euckr_test.txt जनरेट करेंगे।
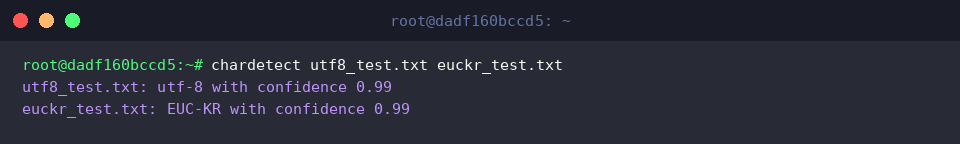
अब दोनों फ़ाइलों को एक साथ chardetect कमांड के आर्ग्युमेंट के रूप में पास करके देखते हैं कि यह टूल उनकी पहचान कैसे करता है।
टर्मिनल आउटपुट स्पष्ट करता है कि utf8_test.txt को UTF-8 के रूप में और euckr_test.txt को EUC-KR के रूप में 99% की असाधारण सटीकता (confidence: 0.99) के साथ सफलतापूर्वक पहचान लिया गया है।
पाइपलाइन इनपुट और बैच लॉग प्रोसेसिंग तकनीक
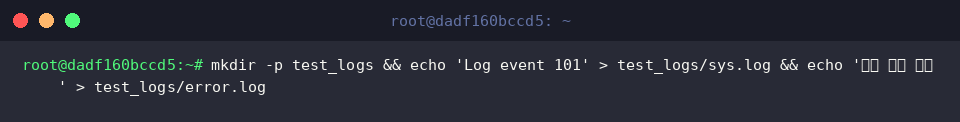
सिस्टम लॉग्स के विश्लेषण हेतु परीक्षण परिवेश तैयार करने के लिए mkdir -p test_logs && echo 'Log event 101' > test_logs/sys.log && echo '서버 에러 로그' > test_logs/error.log कमांड चलाकर डायरेक्टरी और सैंपल लॉग्स निर्मित करते हैं।
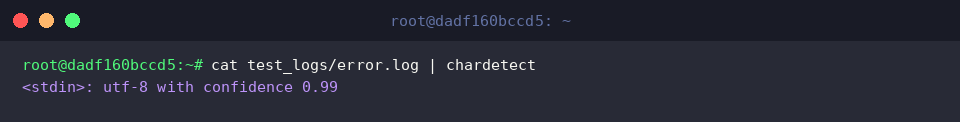
फ़ाइल को सीधे खोलने के स्थान पर cat कमांड और पाइप (|) ऑपरेटर का उपयोग करके डेटा को सीधे chardetect के स्टैंडर्ड इनपुट (stdin) में भेजा जा सकता है।
यहां टूल इनपुट को <stdin> के रूप में ग्रहण करता है और बिना किसी रुकावट के 99% निश्चितता के साथ UTF-8 एन्कोडिंग घोषित करता है।
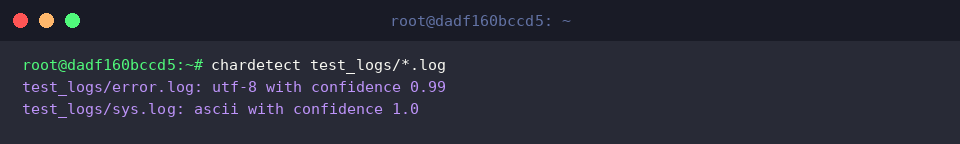
यदि किसी डायरेक्टरी में दर्जनों फ़ाइलें मौजूद हों, तो वाइल्डकार्ड (*) सिंटैक्स के जरिए एक ही झटके में सभी लॉग फ़ाइलों की एन्कोडिंग स्कैन की जा सकती है।
परिणामस्वरूप, कोरियाई कैरेक्टर युक्त error.log को UTF-8 तथा केवल अंग्रेज़ी अक्षरों वाले sys.log को शुद्ध ASCII के रूप में वर्गीकृत किया जाता है।
आंतरिक कार्यप्रणाली और iconv द्वारा फ़ाइल रूपांतरण
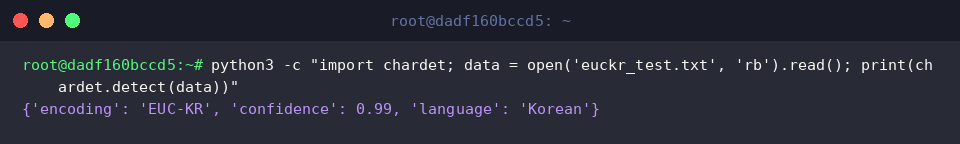
chardetect वास्तव में पायथन की chardet लाइब्रेरी का CLI रैपर है। पायथन वन-लाइनर चलाकर हम सीधे देख सकते हैं कि रॉ बाइट्स की जांच के बाद यह इंजन कैसे निर्णय लेता है।
निष्पादन पर प्राप्त डिक्शनरी आउटपुट में एन्कोडिंग प्रकार (EUC-KR), सांख्यिकीय सटीकता (0.99) और प्रयुक्त भाषा (Korean) का विस्तृत डेटा दिखाई देता है।
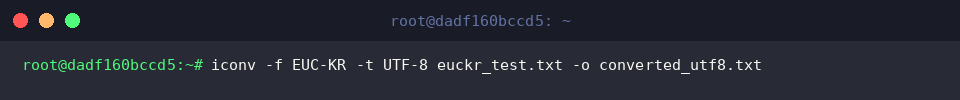
सटीक एन्कोडिंग की पुष्टि हो जाने के बाद, हम iconv टूल का प्रयोग करके euckr_test.txt को मानक UTF-8 प्रारूप वाली converted_utf8.txt में रूपांतरित करते हैं।
सोर्स फॉर्मेट के लिए -f EUC-KR तथा टारगेट के लिए -t UTF-8 फ्लैग निर्धारित करने से टेक्स्ट बिना किसी खराबी के सुरक्षित रूप से नई फ़ाइल में सहेज लिया जाता है।
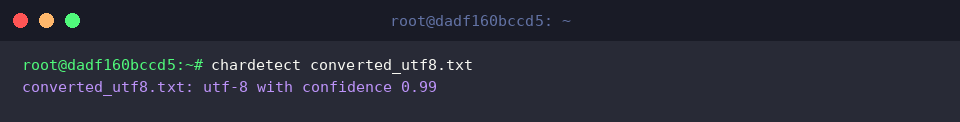
रूपांतरण के उपरांत नई फ़ाइल converted_utf8.txt की दोबारा जांच करके यह सुनिश्चित करते हैं कि कैरेक्टर सेट सही ढंग से बदला है या नहीं।
कमांड चलाने पर फ़ाइल की एन्कोडिंग 99% विश्वसनीयता के साथ UTF-8 के रूप में सत्यापित हो जाती है।
इस प्रकार Linux परिवेश में दूषित या अपठनीय टेक्स्ट फ़ाइलों की समस्या हल करने के लिए chardetect एक बेहद तेज़ और भरोसेमंद समाधान है। जब भी सर्वर पर एन्कोडिंग संबंधी जटिलताएं सामने आएं, इस वर्कफ़्लो को अपनाकर आप डेटा अखंडता आसानी से सुनिश्चित कर सकते हैं।