


概要
Linux環境において大容量テキストファイルやシステムログを解析する際、grepコマンドは必須のツールです。本記事では、Ubuntuターミナルでgrepを実行して目的の文字列を迅速に検索し、出力結果を正確に読み解く実務上の重要テクニックを解説します。
基本的な文字列検索と大文字・小文字を無視するオプション(-i)
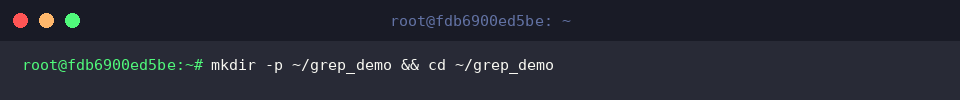
grepコマンドの実習用として独立したワークスペースを作成し、移動するために mkdir -p ~/grep_demo && cd ~/grep_demo コマンドを実行します。
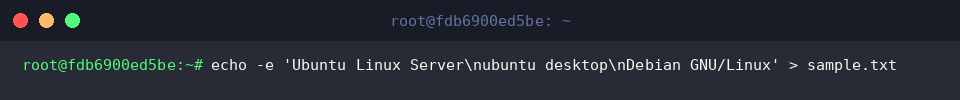
検索テストに使用するサンプル文字列を含んだテキストファイルを作成するために、echo -e 'Ubuntu Linux Server\nubuntu desktop\nDebian GNU/Linux' > sample.txt コマンドを実行します。
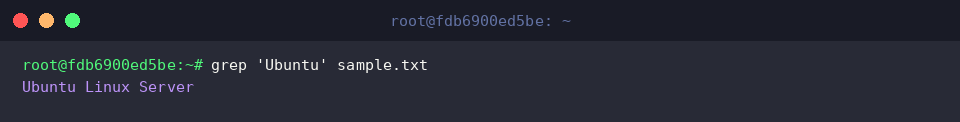
grepコマンドは、ファイルやテキストから特定のパターンや文字列を検索し、一致する行を出力します。
デフォルトの状態では英字の大文字と小文字を厳密に区別するため、Ubuntu と完全に一致する行のみが検索されます。
⚙️ [主要オプション]
-i : 大文字・小文字の区別を無視して一致するパターンを検索します。-v : 指定したパターンと一致しない行のみを反転して出力します。-n : 一致した内容が含まれる行番号を一緒に表示します。-c : 一致した行の合計件数のみをカウントして出力します。-r : サブディレクトリ配下のすべてのファイルを再帰的に検索します。-l : 一致する内容が含まれるファイル名のみを一覧表示します。-E : 拡張正規表現(ERE)を使用して検索します。
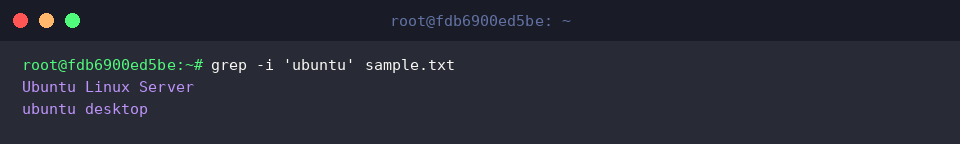
-i オプションを追加すると、大文字と小文字を区別せずに検索します。
そのため、大文字で始まる Ubuntu と小文字で始まる ubuntu が含まれる行が両方出力されます。
行番号の表示(-n)と一致しない行の反転検索(-v)
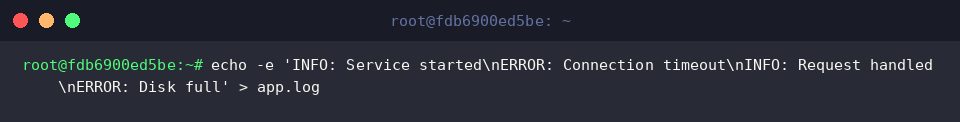
ログ解析の実習で使用する仮想ログデータを作成するために、echo -e 'INFO: Service started\nERROR: Connection timeout\nINFO: Request handled\nERROR: Disk full' > app.log コマンドを実行します。
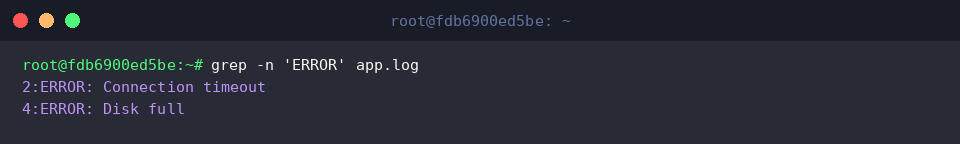
-n オプションを使用すると、検索パターンと一致する行の行番号を合わせて表示します。ERROR 文字列が含まれる行番号と内容が同時に出力されるため、問題の発生箇所を迅速に特定できます。
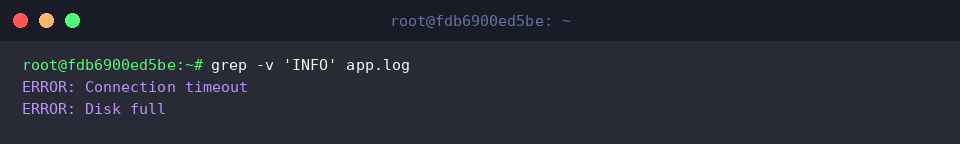
-v オプションを使用すると、指定したパターンと一致しない行のみを反転して出力します。
正常な状態を示す INFO の項目を除外して、エラーに関連する行だけを抽出して確認することができます。
サブディレクトリの再帰検索(-r)とファイル名のみ出力(-l)
再帰検索の実習を行うために、サブアーカイブディレクトリ構造を作成する mkdir -p ~/grep_demo/logs/archive コマンドを実行します。
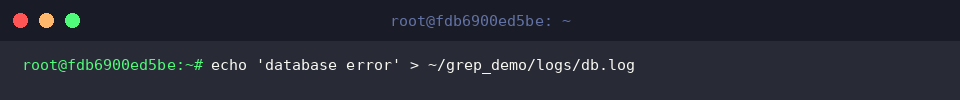
検索テストに使用するデータベースエラーログファイルを作成するために、echo 'database error' > ~/grep_demo/logs/db.log コマンドを実行します。
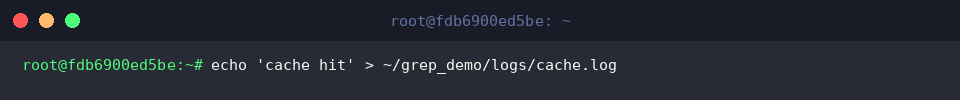
正常ログ確認用のキャッシュログファイルを作成するために、echo 'cache hit' > ~/grep_demo/logs/cache.log コマンドを実行します。
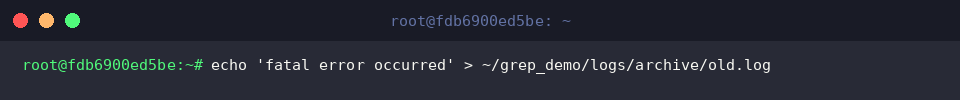
サブディレクトリの探索テストのために、過去のエラーログファイルを作成する echo 'fatal error occurred' > ~/grep_demo/logs/archive/old.log コマンドを実行します。
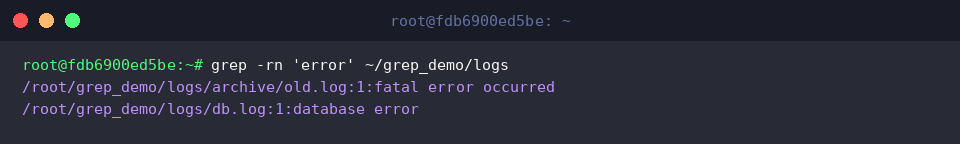
-r オプションと -n オプションを併用すると、サブディレクトリまで再帰的に探索しながら、一致する行の行番号も併せて表示します。logs ディレクトリおよび配下の archive ディレクトリにあるファイルから、error 文字列が含まれるファイルパス、行番号、内容がすべて出力されます。
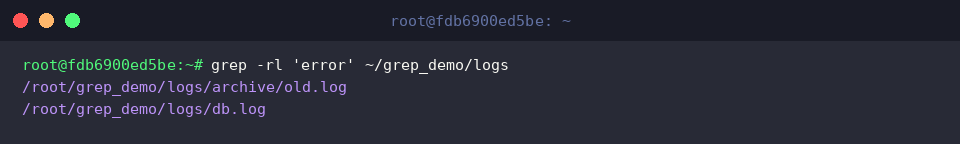
-l オプションを追加して -rl の形式で実行すると、一致した内容の代わりに該当パターンが含まれるファイルのパス一覧のみを出力します。
膨大なログファイルの中から error が発生したファイルだけを素早く絞り込んで確認したい場合に便利です。
検索結果の前後の文脈確認(-A, -B, -C)とカラーハイライト
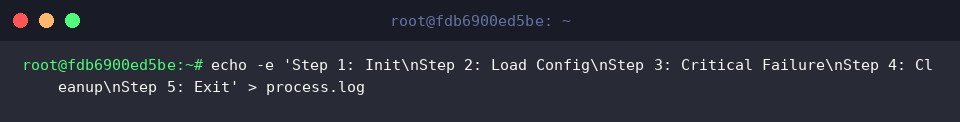
段階的なプロセスの進行状況とエラーの文脈を確認する実習のため、サンプルログファイルを作成する echo -e 'Step 1: Init\nStep 2: Load Config\nStep 3: Critical Failure\nStep 4: Cleanup\nStep 5: Exit' > process.log コマンドを実行します。
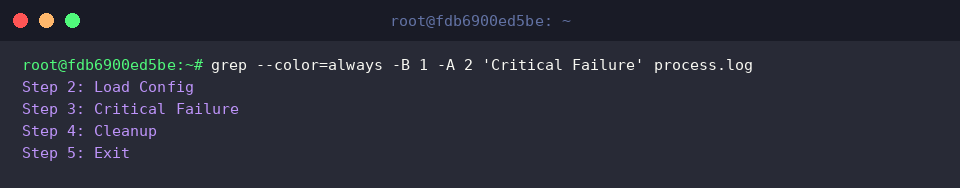
-B オプションと -A オプションを使用すると、一致した行を基準に前(Before)と後ろ(After)の行を指定した行数分まとめて出力します。--color=always オプションで一致した Critical Failure という単語をカラーで強調しながら、直前の1行と直後の2行を一緒に確認することで、エラー発生前後の処理の流れを把握できます。
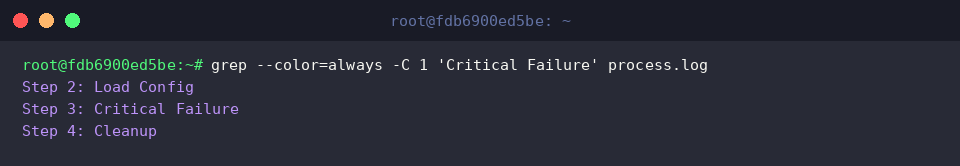
-C オプションを使用すると、一致した行を基準に前後(Context)両方向の行を指定した同じ行数分一度に出力します。Critical Failure が含まれる行の直前1行と直後1行が同時に表示され、重要な文脈をより簡潔に確認することができます。
ここまで、Ubuntu環境におけるgrepコマンドの基本検索オプションから実務でのログ解析活用法まで、重要ポイントを解説しました。
今回学んだパターンを実際のターミナル作業に積極的に活用し、業務効率をさらに向上させてみてください。