


概要
Linux環境において大容量のテキストファイルやログデータを効率的に加工・フィルタリングする際、awkは最も強力なツールです。複雑なスクリプトを書くことなく、わずか1行のワンライナーコマンドで特定列の抽出、条件付きフィルタリング、データの集計まで解決できる基本文法と実践的な活用法を解説します。
1. awkの基本動作原理と特定カラム(列)の抽出
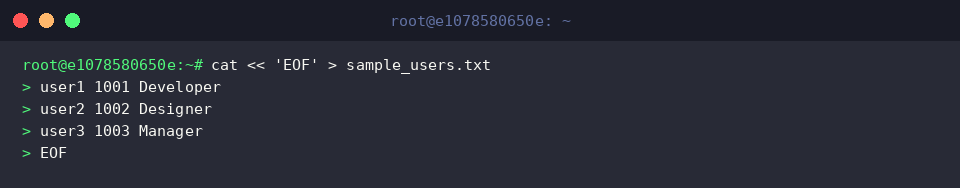
awkコマンドの実習用として、ユーザー名、ID、役職情報が空白で区切られたサンプルのテキストファイルを作成します。
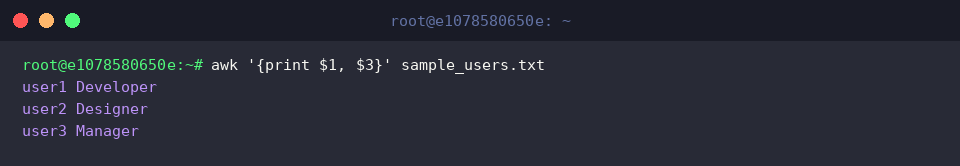
awkコマンドを使用して、ファイルの各行から1番目のフィールド($1)であるユーザー名と、3番目のフィールド($3)である役職を空白区切りで抽出して出力します。awkは特に区切り文字を指定しない場合、デフォルトで連続する空白やタブを基準にフィールドを分割します。
⚙️ [主要オプション]
-F fs : 入力フィールド区切り文字(Field Separator)を指定します。-v var=val : 実行前にawkスクリプト内部で使用する変数と初期値を割り当てます。-f progfile : 実行するawkスクリプトコードが記述されたファイルパスを指定します。
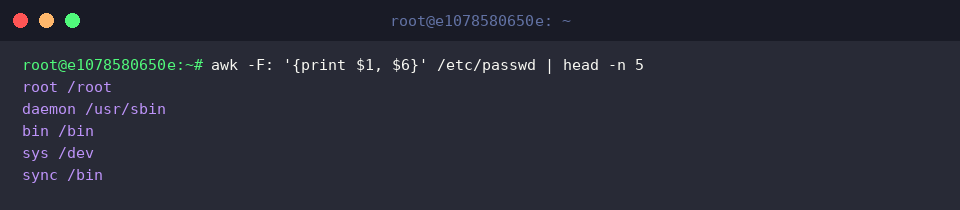
コロン(:)で区切られた/etc/passwdファイルに対して-F:オプションで区切り文字を指定し、1番目のフィールド($1)であるアカウント名と6番目のフィールド($6)であるホームディレクトリのパスのみを抽出して、上位5行を確認します。
2. 条件文と演算子を活用したカスタムデータフィルタリング
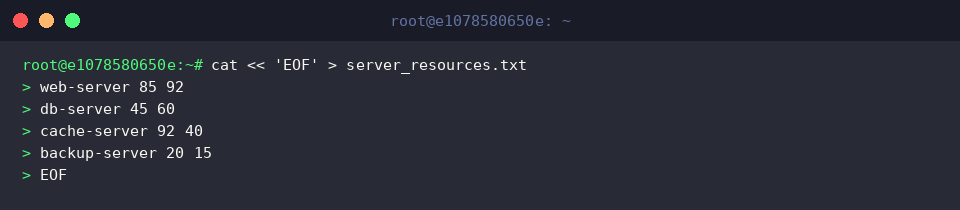
サーバーごとのCPUおよびメモリ使用率データが含まれる実習用のserver_resources.txtファイルを作成します。
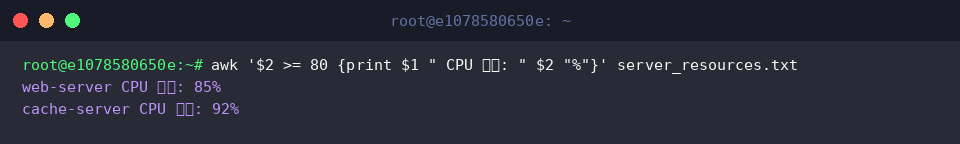
2番目のフィールド($2)であるCPU使用率が80%以上の対象を条件式で抽出し、該当するサーバー名と警告メッセージを出力します。
しきい値を超えたシステムリソースを特定する際に便利に活用できます。
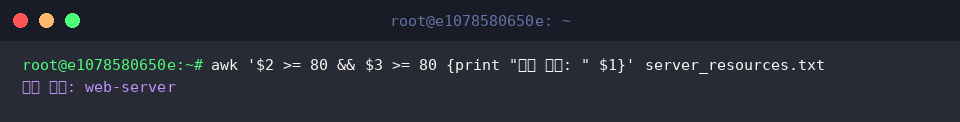
論理AND演算子(&&)を使用して、CPU($2)とメモリ($3)の使用率がともに80%以上の危険なサーバーを絞り込んで出力します。
複合条件を適用することで、複数のリソースが同時にしきい値を超えている対象のみを抽出できます。
3. 組み込み変数とBEGIN/ENDブロックを活用した統計と集計
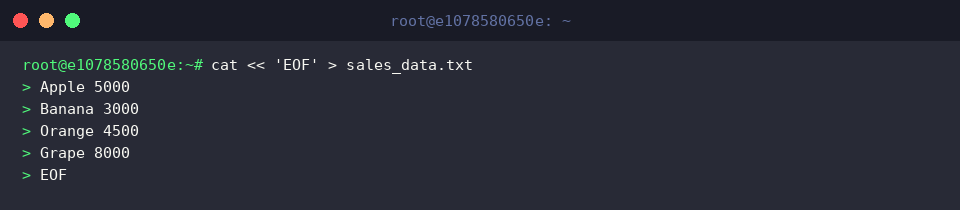
awkを活用したデータ集計および統計実習を行うため、品名と売上額が含まれたsales_data.txtサンプルファイルを作成します。
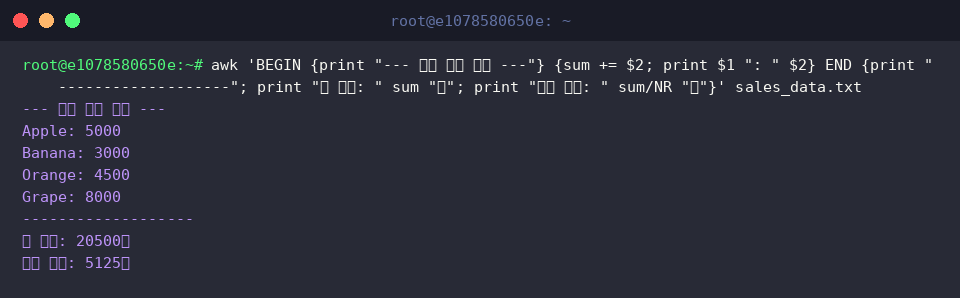
BEGINブロックで本文の処理前に開始の案内メッセージを出力し、各行の2番目のフィールド($2)の値を変数sumに累積加算します。
ファイルの全行処理が完了した後に実行されるENDブロックで、合計売上と組み込み変数NR(総レコード数)を活用した平均売上を計算して出力します。
4. 実務Webサーバーログ解析と異常トラフィックのフィルタリング
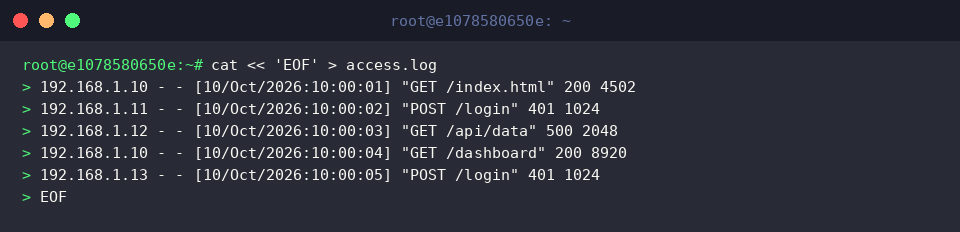
Webサーバーのログ解析およびエラー追跡実習を行うため、NginxおよびApache標準形式のaccess.logサンプルログファイルを作成します。
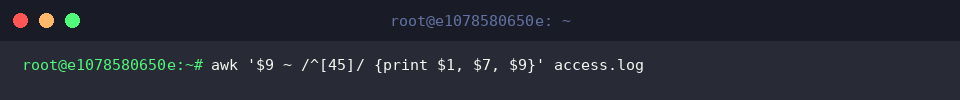
正規表現マッチング演算子(~)を使用して、HTTPステータスコードである9番目のフィールド($9)が4または5で始まる4xxクライアントエラーおよび5xxサーバーエラーの行をフィルタリングします。
条件に一致するログからアクセス元IP($1)、リクエストURI($7)、ステータスコード($9)のみを抽出し、障害や異常トラフィックの発生状況を迅速に確認します。
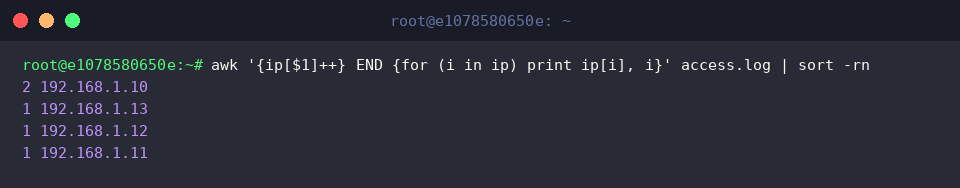
awkの連想配列(ip[$1]++)を活用して各接続元IPごとのリクエスト回数をカウントした後、ENDブロックのループ処理で全体の累積件数を出力し、sort -rnパイプラインを通じてリクエスト頻度が高い順にソートします。
特定IPから発生する過度なトラフィックや異常なアクセス試行を特定する実務的な解析テクニックです。
ここまで、Linux環境でテキスト処理と大容量ログ解析をスムーズに解決できるawkコマンドの基本文法と実務の重要サンプルを簡単にご紹介しました。
今回まとめた多彩なオプションやパターンの活用法を実際の業務にぜひ適用し、反復的なデータ抽出・加工タスクをより効率的に自動化してみてください。