


はじめに
Linuxサーバー上でログの確認やテキスト処理を行う際、文字化けに遭遇した経験は誰にでもあるはずです。適切な文字コード(エンコーディング)を迅速に見極めることは、トラブルシューティングやデータ復元の初手として欠かせません。本稿では、ファイルやストリームの文字セットを高精度に自動識別する強力なユーティリティ chardetect に焦点を当て、パッケージ導入から実践的な判定手順、さらに内部ロジックの仕組みまで網羅的に解説します。
chardetectの導入手順と基本コマンド仕様
Ubuntu環境で chardetect を利用可能にするため、まずはリポジトリ情報を更新した上で python3-chardet パッケージのインストールを実施します。
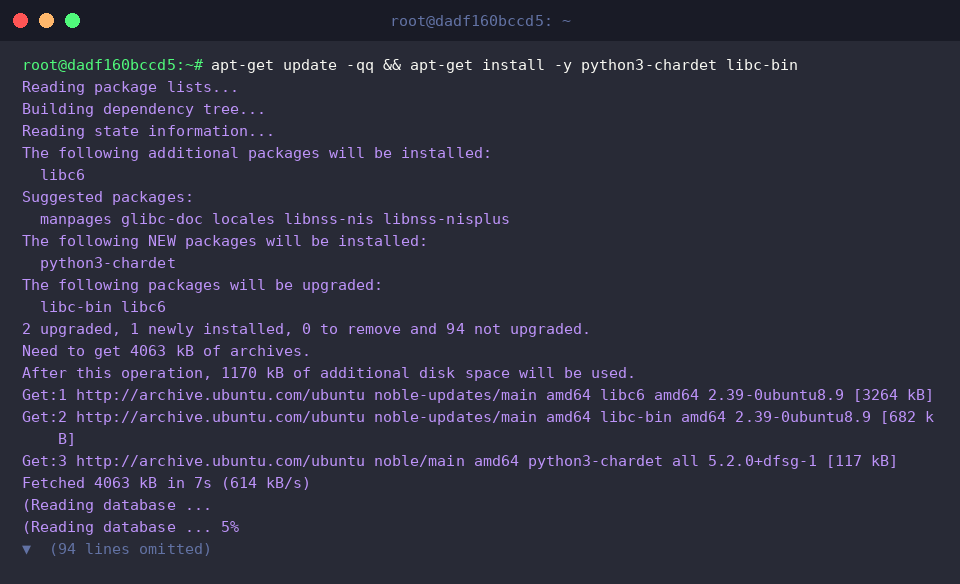
chardetect は、指定されたテキストデータや標準入力ストリームのバイト列を統計的にスキャンし、推測される文字コード名と判定の確信度(Confidenceスコア)を標準出力に提示するCLIツールです。
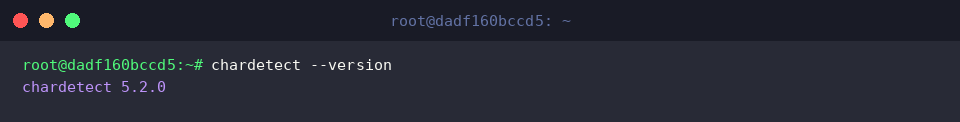
正常にセットアップが完了したかは --version オプションで確認できます。
⚙️ [主要コマンドラインオプション一覧]
-l, --line-per-line : ファイル全体をまとめて解析するのではなく、行単位で個別にエンコーディングを判別します。--minimal : 信頼度スコアなどの詳細情報を省き、特定された文字セット名称のみを簡潔に返します。-h, --help : ヘルプ画面を開き、利用可能な引数やオプションの詳細を表示します。--version : 導入されているツールのバージョン情報を確認して終了します。
検証用サンプルの作成と文字セット判別の実践
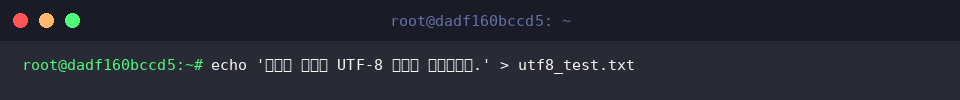
実際の挙動を確かめるため、まずは echo コマンドを用いて標準的なUTF-8形式のテキストファイル utf8_test.txt を生成します。
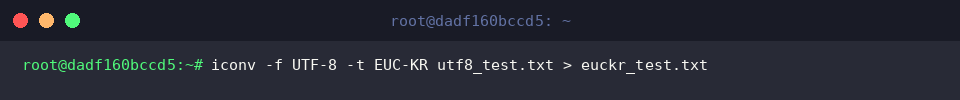
続いて異なるエンコーディングとの比較実験を行うため、iconv コマンドで先ほどのテキストをレガシーなEUC-KR文字コードへと変換し、euckr_test.txt として書き出します。
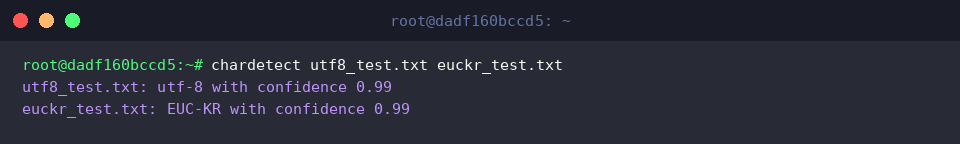
引数に複数のファイルを並べて chardetect を実行すると、対象ファイルごとの推測エンコーディングと判定精度が一覧表示されます。
実行結果からも分かる通り、utf8_test.txt はUTF-8、euckr_test.txt はEUC-KRとして識別され、いずれも99%(confidence: 0.99)という極めて高い確信度で正確に判定されています。
パイプライン連携とワイルドカードによる一括スキャン
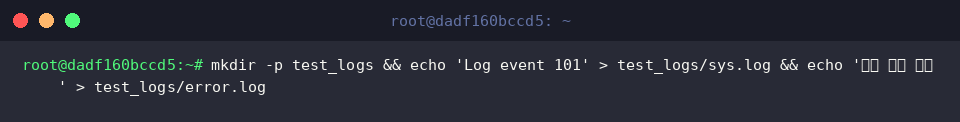
ログの解析フローを再現するため、テスト用ディレクトリ test_logs を作成し、その配下に英数字のみの sys.log と多言語文字列を含む error.log をまとめて準備します。
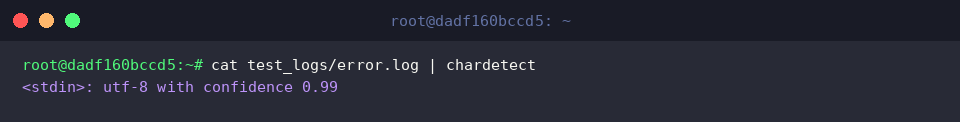
パイプライン演算子(|)を活用し、cat の出力を chardetect の標準入力(stdin)へ直接流し込むことも可能です。
この場合、対象リソースは <stdin> と表記され、入力ストリーム全体がUTF-8(信頼度99%)であると瞬時に特定されます。
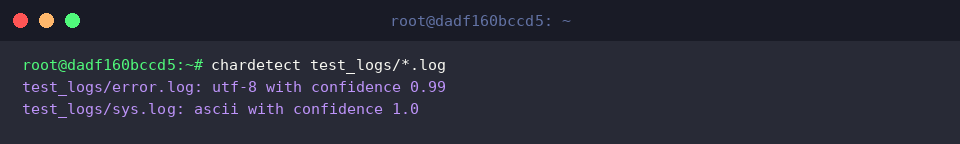
大量のファイルを抱える現場では、ワイルドカード(*)による一括指定が威力を発揮します。test_logs/*.log を指定してスキャンを実行してみましょう。
マルチバイト文字を含む error.log はUTF-8、英数字のみで構成された sys.log はASCIIと、それぞれの特性に応じた最適な文字セットが的確に分類されます。
判定メカニズムの深掘りとiconvによる文字コード正常化
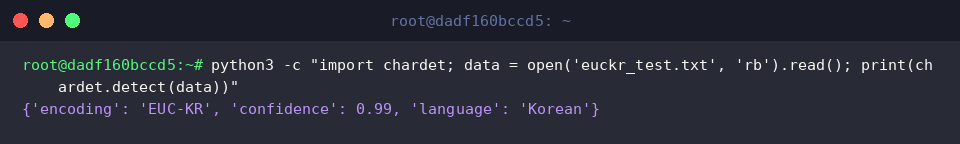
chardetect のバックエンドでは、Pythonの chardet ライブラリがバイトシーケンスの分布パターンを評価しています。ワンライナーを実行してその内部出力を直接覗いてみましょう。
読み込んだバイナリデータを評価した結果、推定エンコーディング(EUC-KR)、統計的確信度(0.99)、言語ファミリー(Korean)が辞書型データとして返却されていることが分かります。
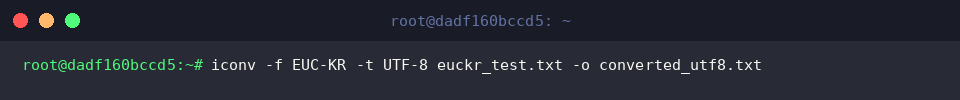
判明した文字セット情報を活用すれば、文字化けの解消も容易です。iconv コマンドの変換元フラグ -f EUC-KR と変換先フラグ -t UTF-8 を明示し、euckr_test.txt を現代的なUTF-8形式の converted_utf8.txt へと再エンコードします。
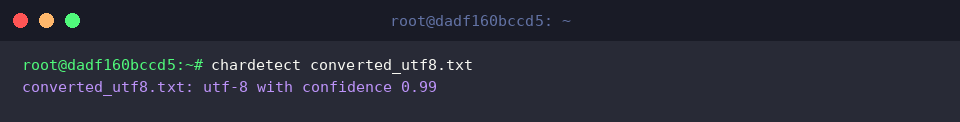
処理後の converted_utf8.txt に対し再度 chardetect を走らせ、変換が意図通り行われたかを最終検証します。
出力結果は確信度99%のUTF-8となっており、文字化けのないクリーンなデータへ正常に変換されたことが確認できました。
テキストの文字コードが不明なまま手探りで変換を試みると、二次的な文字化けやデータ破損を引き起こす原因になります。Linux環境で未知のファイルやログの文字セットに迷った際は、ぜひ chardetect を起点とした確実なワークフローを取り入れてみてください。