


はじめに:cmpコマンドで実現する高速なバイト比較
テキストファイルの行単位の差異を調べる diff とは異なり、cmp コマンドは2つのファイルをバイトレベルで順次スキャンし、異なる箇所の有無を瞬時に検出します。プレーンテキストはもちろん、実行可能ファイルや画像などのバイナリ検証、さらにはシェルスクリプト内の条件判定まで、現場で役立つ実践的なテクニックを体系的に解説します。
基本的な使い方:最初の不一致箇所(バイト・行)を素早く特定する
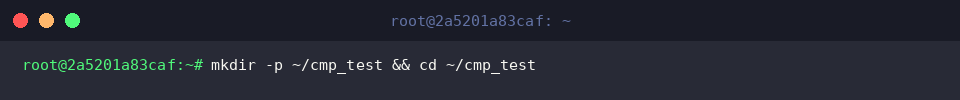
検証用の作業スペースを用意するため、mkdir -p ~/cmp_test && cd ~/cmp_test を実行して専用ディレクトリを作成・移動します。
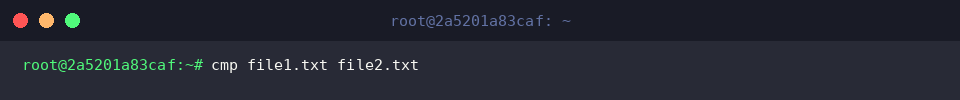
動作テストに使用するファイルとして、同一の内容を持つ file1.txt・file2.txt と、一部の文字列を変えた file3.txt を echo コマンドで生成します。

引数に対象ファイルを2つ渡して実行すると、cmp は先頭バイトから照合を行います。中身が完全に一致していれば何も出力せずに終了ステータス 0 を返します。
⚙️ [押さえておきたい主要オプション]
-b : 相違箇所のバイト値(8進数)と対応するASCII文字を併記して表示します。-l : ファイル内で異なるすべてのバイト位置とそれぞれの値をリスト形式で一覧表示します。-n : 検証対象を先頭から指定したバイト数までに制限します。-i : ファイル冒頭の指定バイト数をスキップしてから比較を開始します。-s : 一切の標準出力を抑止し、終了ステータス(一致なら 0、不一致なら 1)のみを返します。
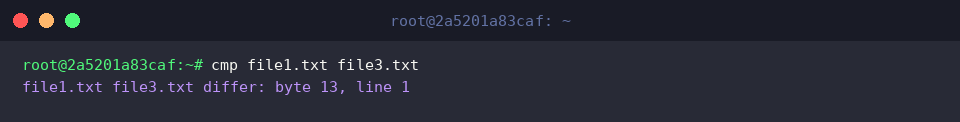
次に、差異が存在する組み合わせである cmp file1.txt file3.txt を実行してみます。
内容の異なる箇所に到達した段階で処理が停止し、最初に検出されたバイト位置および行番号がターミナルに出力されます。
差分の詳細可視化:全不一致バイトの一覧表示と文字情報の取得 (-l, -b)
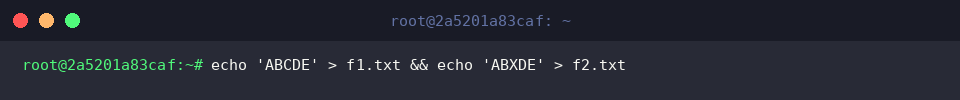
より細かなバイナリレベルの違いを把握するために、異なるアルファベットを含むテストファイル f1.txt と f2.txt を準備します。
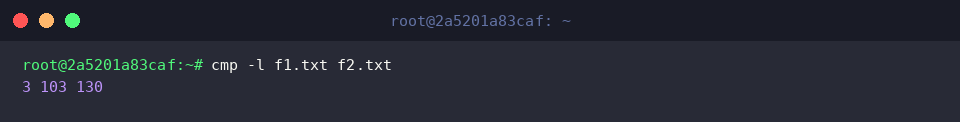
-l オプションを付与して cmp -l f1.txt f2.txt を実行すると、不一致となったすべてのバイト位置と、各ファイルにおけるバイト値(8進表記)が網羅的にリストアップされます。
以下の例では、3バイト目において1つ目のファイルが 8進数 103(C)、2つ目のファイルが 8進数 130(X)であることが確認できます。
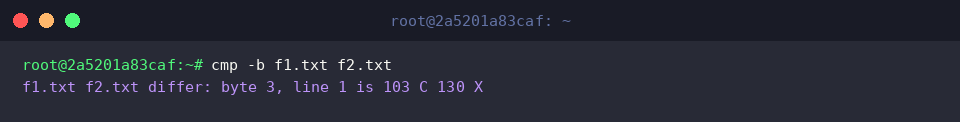
バイト値だけでなく実際の文字を直感的に確認したい場合は -b を指定します。cmp -b f1.txt f2.txt を実行することで、3バイト目に生じた 103(C)と 130(X)の差異が文字情報とともに明示されます。
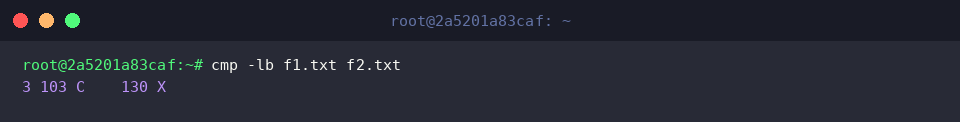
両方のフラグを組み合わせた cmp -lb f1.txt f2.txt を活用すれば、差分のある全バイトの位置番号・8進数コード・ASCII文字が1行に整理されて出力されるため、バイナリ解析やデータ破損チェックの効率が大幅に向上します。
スクリプト自動化:サイレントモードと終了ステータスの判定 (-s)
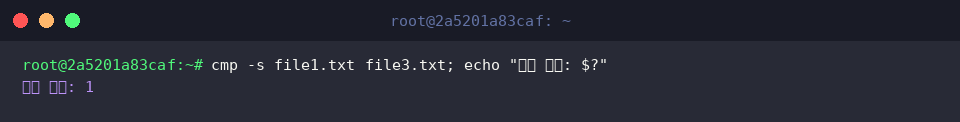
バッチ処理やCI/CDパイプラインへの組み込みには、出力を出さずに戻り値のみで結果を判別できる -s オプションが威力を発揮します。
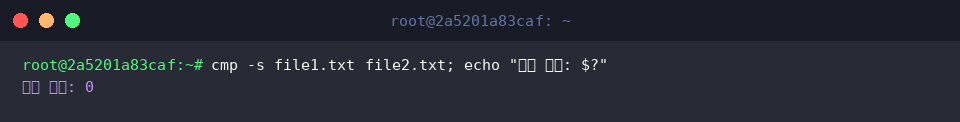
内容が合致する2つのファイルを照合した場合、正常一致を示すコード 0 が $? にセットされます。
一方、差異が存在するファイル同士を -s オプションで比較すると、コンソールには何も表示されず、不一致を意味するステータス 1 が返されます。
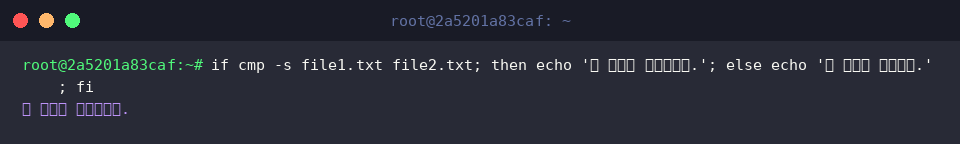
シェルスクリプトの if 文に cmp -s を直接組み込むことで、ファイル同一性に応じた柔軟な条件分岐を極めてシンプルに記述できます。
対象ファイルが完全一致する場合、条件式が真(戻り値 0)と評価され、対応する処理ブロックが実行されます。
検証範囲の制御:特定バイトのスキップ(-i)と上限サイズ指定(-n)
固定ヘッダーを除外してペイロードのみを検証したい場合や、ファイル先頭のシグネチャのみを素早くチェックしたいケースでは、範囲指定オプションが役立ちます。
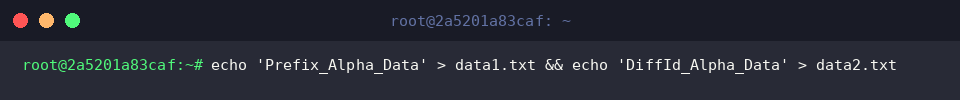
プレフィックス部分のみが異なり、後続データが共通している data1.txt と data2.txt を作成して挙動をテストします。
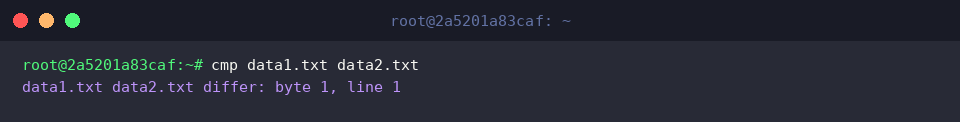
オプションなしで cmp data1.txt data2.txt を実行すると、先頭文字が相違しているため、1バイト目で差分が検知されます。
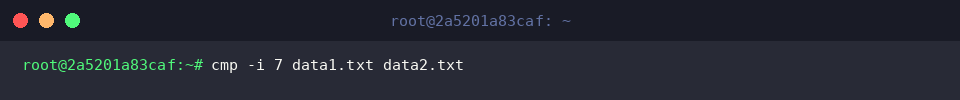
先頭のヘッダー相当部(7バイト分)を読み飛ばすには -i 7 を指定します。
スキップ以降のデータ列(Alpha_Data)は両者で完全に一致しているため、不一致エラーは出ず無言で正常終了します。
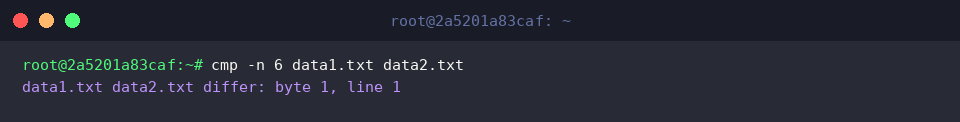
逆に、冒頭の特定ブロックだけを照合したい場合は -n を使用します。-n 6 を付与して先頭から最大6バイトに絞り込んで比較を実行すると、指定枠内の1バイト目で異なるため、差分メッセージが即座に返されます。
大容量ファイルの高速な完全性確認から、ヘッダーを無視したバイナリ検証、自動化スクリプトでのサイレント判定まで、cmp コマンドの機能を把握しておくことでLinux環境でのファイル管理業務をより効率的に進めることができます。ぜひ日々の運用に取り入れてみてください。