


はじめに
Linux環境でテキストデータを処理する際、2つのファイル間の一致箇所や相違点をすばやく突き合わせたい場面は頻繁に発生します。本記事では、標準ユーティリティである comm コマンドの仕組みと実務での活用法をハンズオン形式で解説します。特徴的な3カラム出力の構造理解から、オプションによる積集合・差集合の抽出、パイプラインやプロセス置換を組み合わせた効率的なデータ照合テクニックまでを網羅します。
1. commコマンドの基本仕様と3列カラム出力の仕組み
検証作業をスムーズに進めるため、専用の検証ディレクトリを作成してカレントディレクトリを切り替えます。
mkdir -p ~/comm_lab && cd ~/comm_lab を実行します。
比較対象となる1つ目のテストデータとして、あらかじめアルファベット順に整列された fruits_a.txt を生成します。
printf "apple\nbanana\ncherry\nmango\n" > fruits_a.txt を実行します。
続いて照合対象となる2つ目のソート済みサンプルファイル fruits_b.txt を用意します。
printf "banana\ncherry\norange\nwatermelon\n" > fruits_b.txt を実行します。
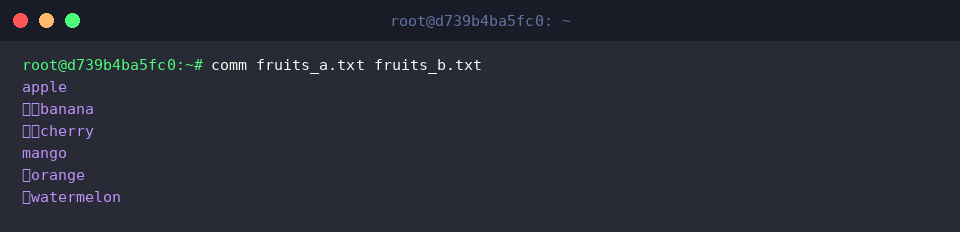
comm コマンドは、あらかじめソートされた2つのテキストファイルを行単位で読み込み、内容を対照して3つの列(カラム)に振り分けて出力します。
デフォルトの表示形式では、第1列(インデントなし)に1つ目のファイルのみに含まれる行、第2列(タブ1個)に2つ目のファイルのみに含まれる行、そして第3列(タブ2個)に双方に共通して存在する行が配置されます。
⚙️ [主なコマンドオプション]
-1 : 第1ファイル固有の行(第1列)を非表示にします。-2 : 第2ファイル固有の行(第2列)を非表示にします。-3 : 両ファイル共通の行(第3列)を非表示にします。--check-order : 入力データが正しい順序でソートされているかを厳密に検証します。--nocheck-order : 入力ファイルのソート状態チェックをスキップします。--output-delimiter=STR : 列の区切り文字をデフォルトのタブから指定した文字列(STR)に置き換えます。
2. 数値オプションを用いた積集合・差集合のフィルタリング
検証ファイルが配置されているディレクトリを作業場所として指定します。
cd ~/comm_lab を実行します。
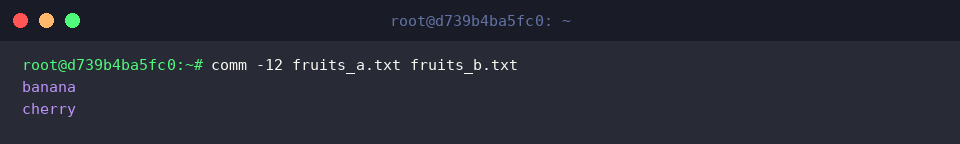
-12 オプションを指定すると、第1列と第2列の表示が抑制され、2つのファイル双方に含まれる共通行(積集合)のみを抽出できます。
実行すると、両方のリストに登録されている banana と cherry のみが画面に現れます。
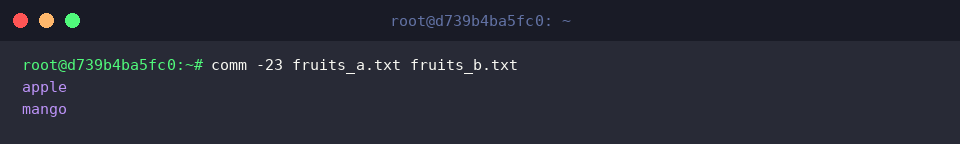
今度は第1ファイル側にしか存在しない固有の要素(差集合 A-B)を取り出すため、第2列と第3列を除外する -23 を指定します。
この操作により、fruits_a.txt にのみ記述されている apple および mango が抽出されます。
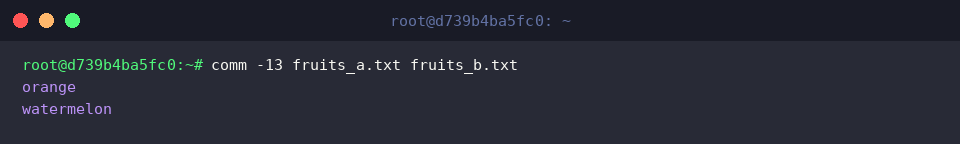
逆に、第2ファイル側だけが持つ固有データ(差集合 B-A)を確認したい場合は、第1列と第3列をマスクする -13 を使用します。
その結果、fruits_b.txt にしか含まれていない orange と watermelon が表示されます。
3. 未ソートファイルの比較:Bashのプロセス置換を活用する手法
次の検証に向けて、対象ディレクトリ内にいることを確認します。
cd ~/comm_lab を実行します。
ソートされていない生データを比較するシチュエーションを再現するため、順序がバラバラなテストファイル unsorted_a.txt を作成します。
printf "zebra\napple\ngrape\n" > unsorted_a.txt を実行します。
同様に、未整列状態の対照用ファイル unsorted_b.txt を用意します。
printf "apple\norange\nzebra\n" > unsorted_b.txt を実行します。
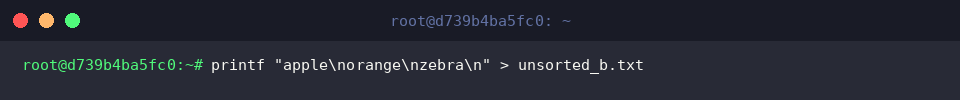
comm は入力データが整列済みであることを前提としているため、Bashのプロセス置換構文(<(...))を利用してメモリ上でソートを行い、その出力を直接 comm へ渡します。これにより一時ファイルを生成する手間が省けます。
実行コマンド comm <(sort unsorted_a.txt) <(sort unsorted_b.txt) では、動的に整列されたデータに基づき、第1列に grape、第2列に orange、第3列に共通要素の apple と zebra が正しく分類されて出力されます。
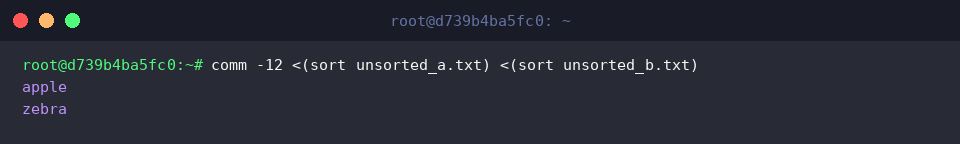
さらに -12 オプションをプロセス置換と組み合わせることで、事前のファイル加工なしに未整列ファイル間の共通項目だけを直接取得可能です。comm -12 <(sort unsorted_a.txt) <(sort unsorted_b.txt) を実行すると、両ファイルに重複して存在する apple と zebra がスムーズにリストアップされます。
4. 実務シナリオ:パッケージ構成の比較と大文字小文字の取り扱い
検証用ディレクトリへ移動します。
cd ~/comm_lab を実行します。
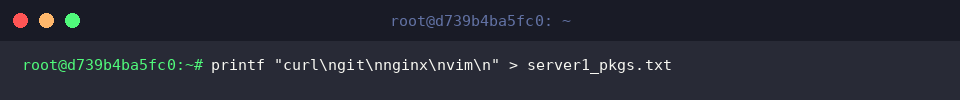
複数サーバー間の導入パッケージ差異を調査する実務を想定し、1台目のサーバー構成を模した server1_pkgs.txt を作成します。
printf "curl\ngit\nnginx\nvim\n" > server1_pkgs.txt を実行します。
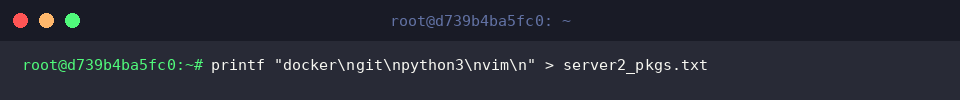
比較対象となる2台目のサーバー構成ファイル server2_pkgs.txt を作成します。
printf "docker\ngit\npython3\nvim\n" > server2_pkgs.txt を実行します。
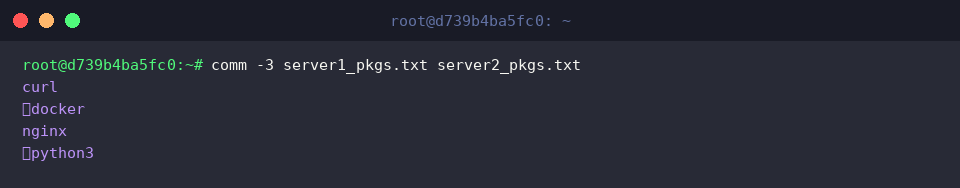
2台のサーバーで共通して稼働しているソフトウェアを除外し、どちらか片方のみに導入されている固有パッケージを洗い出すには -3 オプションが最適です。comm -3 server1_pkgs.txt server2_pkgs.txt を実行すると、共通の git や vim はマスクされ、サーバー1限定の curl・nginx、およびサーバー2限定の docker・python3 が左右の列に切り分けて提示されます。
次に、大文字と小文字が混在したケースの挙動を検証します。まずテストデータ mixed_a.txt を作成します。
printf "Apple\nBANANA\ncherry\n" > mixed_a.txt を実行します。
続いて対照ファイル mixed_b.txt を用意します。文字列のスペルは同じですがケースが異なっています。
printf "apple\nbanana\nCHERRY\n" > mixed_b.txt を実行します。
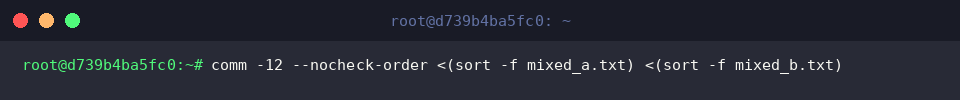
sort -f を用いて大文字小文字を同一視して並べ替えたストリームを渡す際、ロケール起因の順序警告を回避するために --nocheck-order を併用します。comm -12 --nocheck-order <(sort -f mixed_a.txt) <(sort -f mixed_b.txt) を実行してみましょう。comm は内部的に厳密なバイト単位(ASCIIコード値)の一致判定を行うため、ソート順序は大文字小文字を無視して揃えられていても、文字列そのもののケースが異なる行は一致とはみなされず、共通行としては何も出力されません。
以上、Linuxにおける comm コマンドを活用したファイル比較と効率的な行抽出の手順を解説しました。sort や各種フィルタリングオプションを適切に組み合わせることで、インフラ構築時の差分監査や膨大なログの突合調査をコマンドライン上で素早く完結させることができます。