


개요
리눅스 환경에서 대용량 텍스트 파일이나 로그 데이터를 효율적으로 가공하고 필터링할 때 awk는 가장 강력한 도구입니다. 복잡한 스크립트 작성 없이 단 한 줄의 명령어로 특정 열 추출, 조건부 필터링, 데이터 합산까지 해결하는 핵심 문법과 실무 활용법을 알아봅니다.
1. awk 기본 동작 원리와 특정 컬럼(열) 추출하기
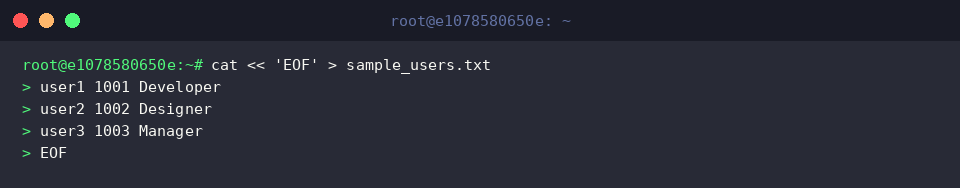
awk 명령어 실습을 위해 사용자명, ID, 직무 정보가 공백으로 구분된 예제 텍스트 파일을 생성합니다.
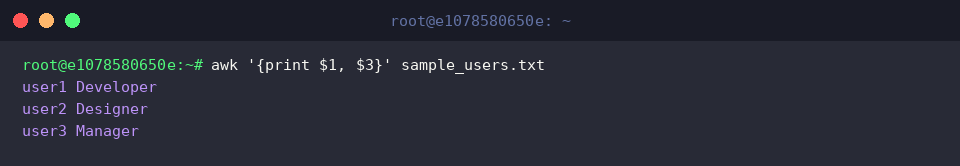
awk 명령어를 사용하여 파일의 각 행에서 첫 번째 필드($1)인 사용자명과 세 번째 필드($3)인 직무를 공백을 구분자로 삼아 추출하여 출력합니다.awk는 별도의 구분자 지정이 없으면 기본적으로 연속된 공백이나 탭을 기준으로 필드를 나눕니다.
⚙️ [주요 옵션]
-F fs : 입력 필드 구분자(Field Separator)를 지정합니다.-v var=val : 실행 전 awk 스크립트 내부에서 사용할 변수와 초기값을 할당합니다.-f progfile : 실행할 awk 스크립트 코드가 작성된 파일 경로를 지정합니다.
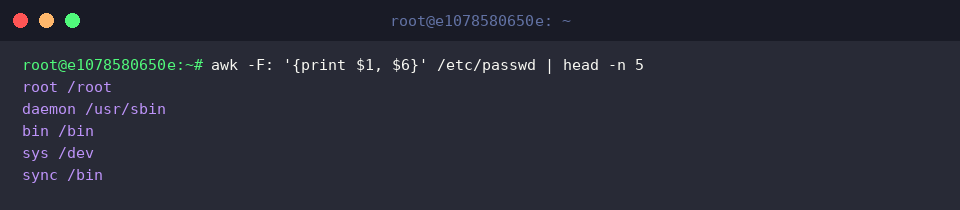
콜론(:)으로 구분된 /etc/passwd 파일에서 -F: 옵션으로 구분자를 지정한 뒤, 첫 번째 필드($1)인 계정명과 여섯 번째 필드($6)인 홈 디렉터리 경로만 추출하여 상위 5개 행을 확인합니다.
2. 조건문과 연산자를 활용한 맞춤형 데이터 필터링
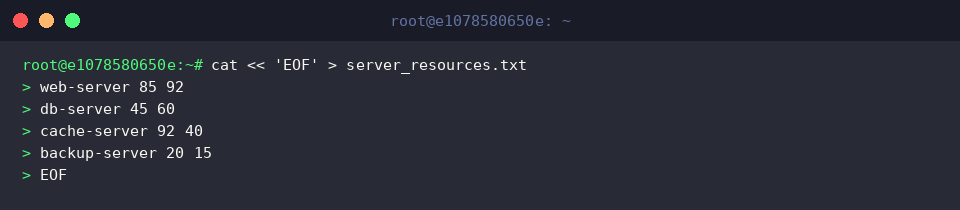
서버별 CPU 및 메모리 사용률 데이터가 포함된 실습용 server_resources.txt 파일을 생성합니다.
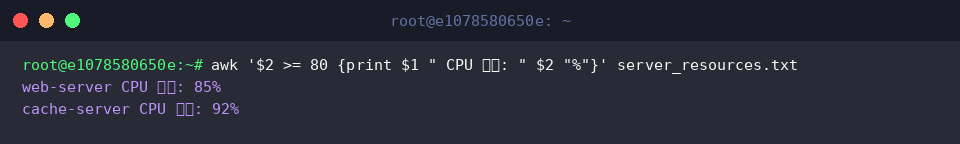
두 번째 필드($2)인 CPU 사용률이 80% 이상인 대상을 조건식으로 선별하여 해당 서버명과 경고 문구를 출력합니다.
임계치를 초과한 시스템 리소스를 식별할 때 유용하게 활용할 수 있습니다.
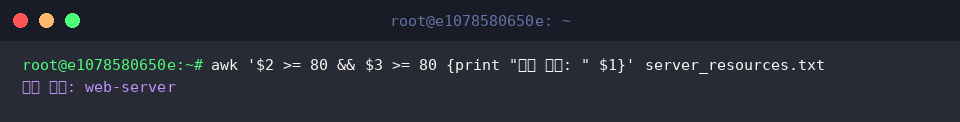
논리 AND 연산자(&&)를 사용하여 CPU($2)와 메모리($3) 사용률이 모두 80% 이상인 위험 서버를 선별하여 출력합니다.
복합 조건을 적용하여 여러 리소스가 동시에 임계치를 넘긴 대상만 선별할 수 있습니다.
3. 내장 변수와 BEGIN/END 블록을 활용한 통계 및 합산
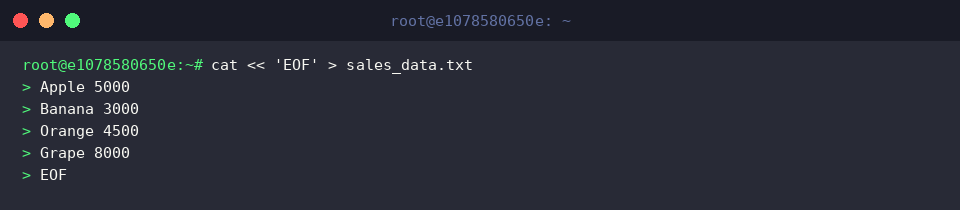
awk를 활용한 데이터 집계 및 통계 실습을 진행하기 위해 품목명과 매출액이 포함된 sales_data.txt 예제 파일을 생성합니다.
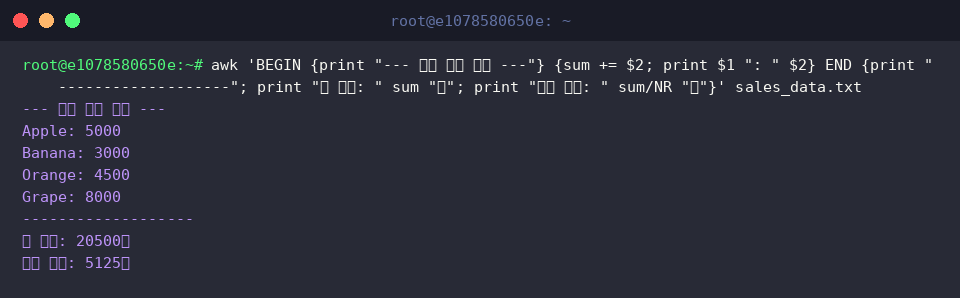
BEGIN 블록으로 본문 처리 전 시작 안내 문구를 출력하고, 각 행의 두 번째 필드($2) 값을 변수 sum에 누적 합산합니다.
파일의 모든 행 처리가 끝난 뒤 실행되는 END 블록에서 총 매출과 내장 변수 NR(전체 레코드 수)을 활용한 평균 매출을 계산하여 출력합니다.
4. 실무 웹 서버 로그 분석 및 이상 트래픽 필터링
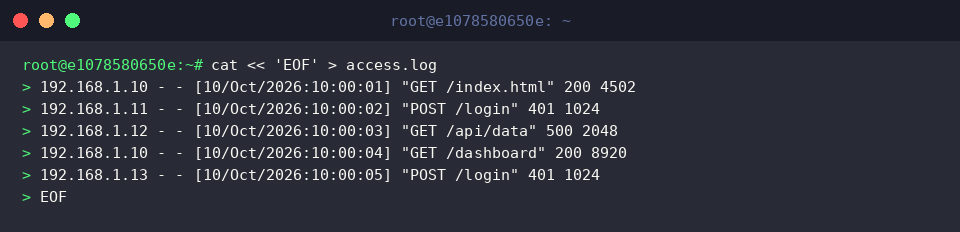
웹 서버 로그 분석 및 에러 추적 실습을 진행하기 위해 Nginx 및 Apache 표준 형식의 access.log 예제 로그 파일을 생성합니다.
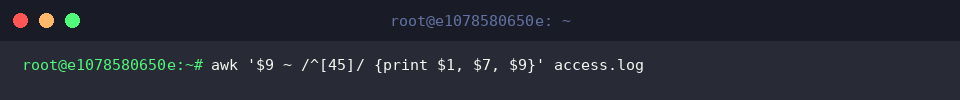
정규표현식 매칭 연산자(~)를 사용하여 HTTP 상태 코드인 아홉 번째 필드($9)가 4 또는 5로 시작하는 4xx 클라이언트 에러 및 5xx 서버 에러 행을 필터링합니다.
조건에 부합하는 로그에서 접속 IP($1), 요청 URI($7), 상태 코드($9)만 추출하여 장애 및 이상 트래픽 발생 현황을 빠르게 확인합니다.
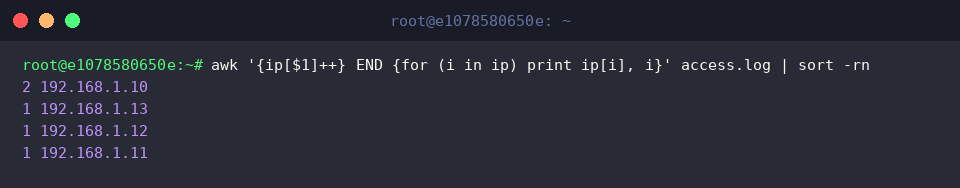
awk의 연관 배열(ip[$1]++)을 활용하여 각 접속 IP별 요청 횟수를 카운트한 뒤, END 블록의 반복문으로 전체 누적 건수를 출력하고 sort -rn 파이프라인을 통해 요청 빈도가 높은 순서대로 정렬합니다.
특정 IP로부터 발생하는 과도한 트래픽이나 비정상적인 접근 시도를 식별하는 실무 분석 기법입니다.
지금까지 리눅스 환경에서 텍스트 처리와 대용량 로그 분석을 손쉽게 해결해 주는 awk 명령어의 기본 문법과 실무 핵심 예제들을 간단하게 살펴보았습니다.
오늘 정리한 다양한 옵션과 패턴 활용법을 실무 작업에 바로 적용해 보시면서 반복적인 데이터 추출 및 가공 업무를 한층 더 효율적으로 자동화해보시기 바랍니다.