


개요
리눅스 환경에서 문서나 로그 파일의 문자셋이 깨질 때 정확한 인코딩 방식을 파악하는 것은 매우 중요합니다. 본 글에서는 chardetect 명령어의 설치부터 다양한 인코딩 감지 실습 및 내부 동작 원리를 단계별로 살펴봅니다.
chardetect 도구 설치 및 환경 구성
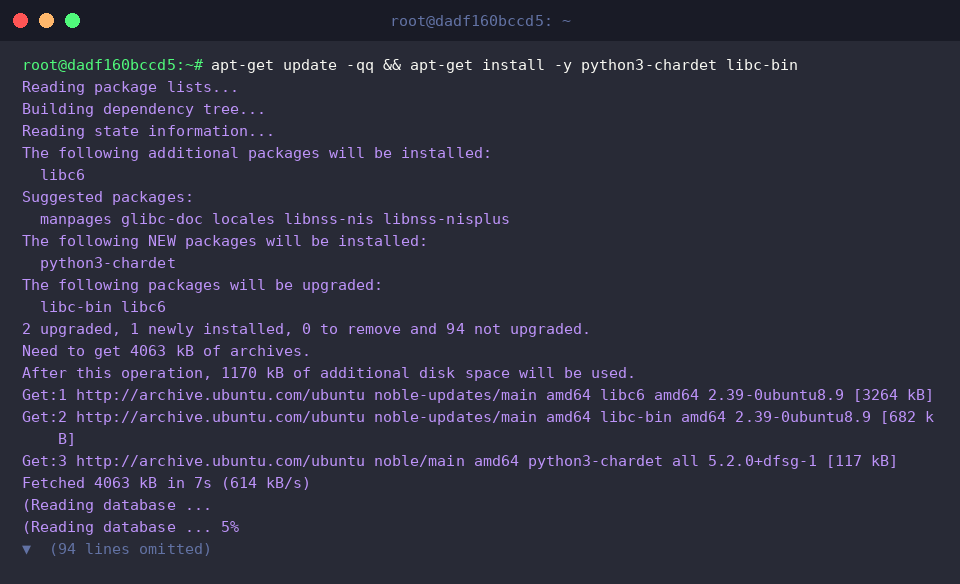
chardetect 명령어 실습을 위해 시스템 패키지 목록을 최신화하고 python3-chardet 패키지를 설치합니다.
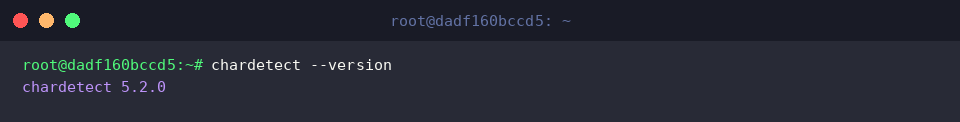
chardetect 명령어는 텍스트 파일이나 입력 스트림의 문자 인코딩(Charset)과 신뢰도를 감지하여 출력합니다.--version 옵션은 현재 설치된 chardetect 도구의 버전을 확인합니다.
⚙️ [주요 옵션]
-l, --line-per-line : 파일 전체 대신 각 줄 단위로 문자 인코딩을 분석합니다.--minimal : 신뢰도 점수를 제외하고 감지된 인코딩 이름만 간단히 출력합니다.-h, --help : 도움말 메시지와 사용 가능한 옵션 목록을 출력합니다.--version : 프로그램의 버전 정보를 표시하고 종료합니다.
다양한 인코딩 샘플 파일 생성 및 문자셋 감지 실습
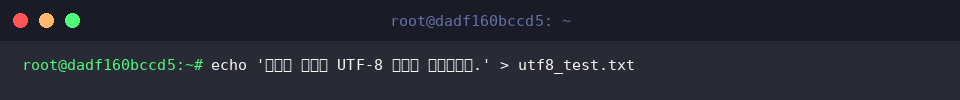
인코딩 감지 실습에 필요한 기본 문서를 준비하기 위해 echo 명령어를 사용하여 UTF-8 형식의 utf8_test.txt 파일을 생성합니다.
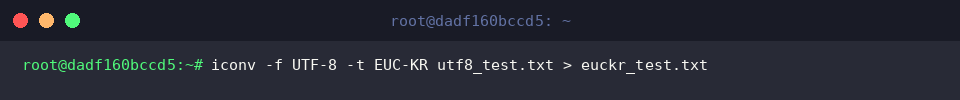
다양한 인코딩 비교 실습을 위해 iconv 명령어를 사용하여 UTF-8 텍스트를 EUC-KR 인코딩으로 변환한 euckr_test.txt 파일을 생성합니다.
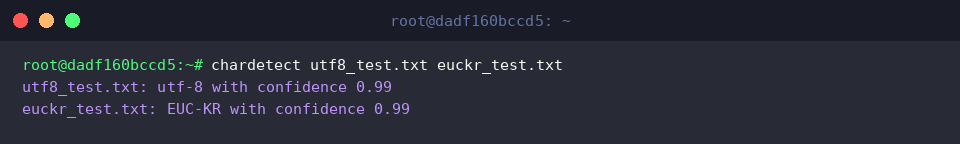
chardetect 명령어 뒤에 대상 파일들을 나란히 지정하여 각 문서의 문자 인코딩과 분석 신뢰도를 확인합니다.
실행 결과 utf8_test.txt는 UTF-8, euckr_test.txt는 EUC-KR 인코딩으로 각각 99%의 높은 신뢰도와 함께 정확하게 감지됩니다.
표준 입력 파이프라인 및 다중 파일 일괄 분석
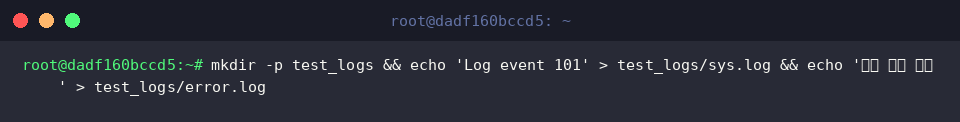
로그 파일 인코딩 분석 실습 환경을 준비하기 위해 mkdir -p test_logs && echo 'Log event 101' > test_logs/sys.log && echo '서버 에러 로그' > test_logs/error.log 명령어를 실행하여 테스트 디렉터리와 샘플 로그 파일들을 생성합니다.
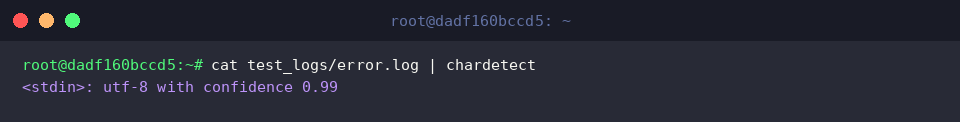
cat 명령어와 파이프(|)를 연결하여 텍스트 파일 내용을 chardetect의 표준 입력(stdin)으로 전달합니다.
실행 결과 파일명 대신 <stdin> 형태로 입력 스트림을 인식하여 UTF-8 인코딩을 99% 신뢰도로 감지합니다.
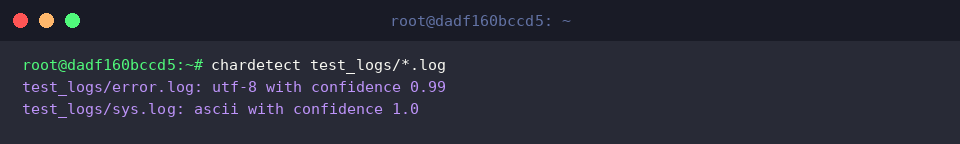
와일드카드(*) 패턴을 사용하여 test_logs 디렉터리에 위치한 모든 로그 파일의 인코딩을 한 번에 일괄 분석합니다.
실행 결과 한글이 포함된 error.log 파일은 UTF-8로, 영문으로 구성된 sys.log 파일은 ASCII 인코딩으로 각각 정확하게 판별됩니다.
chardetect 동작 원리 및 iconv 연계 인코딩 변환
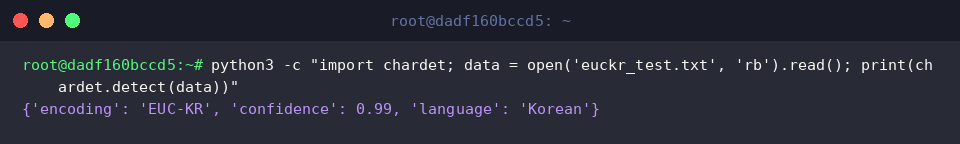
파이썬의 chardet 모듈을 직접 호출하여 chardetect 도구의 기반이 되는 바이트 시퀀스 분석 결과를 확인합니다.
실행 결과 원본 파일의 바이트 데이터를 분석하여 인코딩 방식(EUC-KR), 통계적 신뢰도(0.99), 사용 언어(Korean) 정보가 딕셔너리 형태로 출력됩니다.
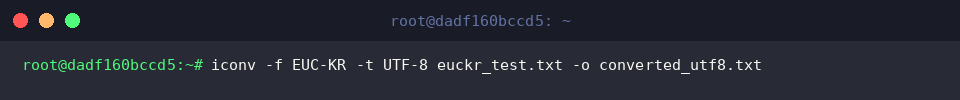
감지된 인코딩 정보를 바탕으로 iconv 명령어를 사용하여 euckr_test.txt 문서의 내용을 UTF-8 형식의 converted_utf8.txt 파일로 변환합니다.-f EUC-KR 옵션으로 원본 인코딩을 지정하고 -t UTF-8 옵션으로 변환 대상 인코딩을 설정하여 텍스트 깨짐 없이 안전하게 새 파일로 저장합니다.
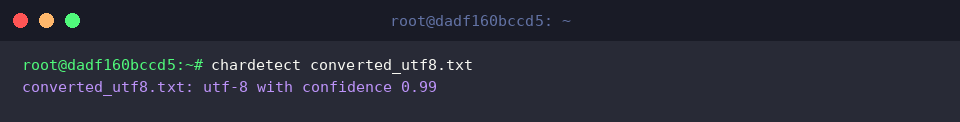
변환이 완료된 converted_utf8.txt 파일의 인코딩 상태를 chardetect 명령어로 다시 검증합니다.
실행 결과 문서의 인코딩이 UTF-8로 변경되었으며 99%의 높은 신뢰도로 정확하게 변환되었음을 확인합니다.
지금까지 리눅스 환경에서 텍스트 파일의 인코딩을 정확하게 감지해 깨짐 문제를 해결할 수 있는 chardetect 명령어의 설치 및 활용법을 간단하게 살펴보았습니다.
파일 인코딩 확인이 필요할 때 유용하게 활용해 보시기 바랍니다.