


概述
在 Linux 环境下分析大容量文本文件或系统日志时,grep 命令是一项必不可少的工具。本文将介绍在 Ubuntu 终端中运行 grep 快速查找目标字符串,并准确解读输出结果的实战核心技巧。
基本字符串搜索与忽略大小写选项(-i)
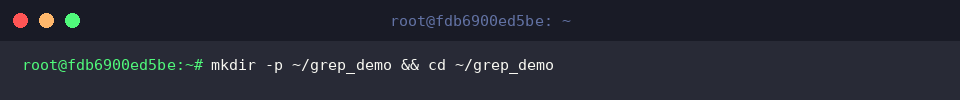
为了创建并切换到用于练习 grep 命令的独立工作空间,运行 mkdir -p ~/grep_demo && cd ~/grep_demo 命令。
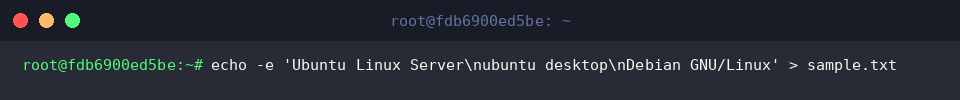
为了创建包含用于搜索测试的示例字符串的文本文件,运行 echo -e 'Ubuntu Linux Server\nubuntu desktop\nDebian GNU/Linux' > sample.txt 命令。
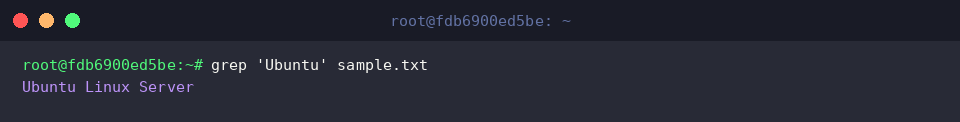
grep 命令用于在文件或文本中搜索特定模式或字符串,并输出匹配的行。
默认情况下会严格区分英文大小写,因此只会检索精确匹配 Ubuntu 的行。
⚙️ [主要选项]
-i : 忽略大小写并搜索匹配的模式。-v : 反转查找,仅输出与指定模式不匹配的行。-n : 同时显示包含匹配内容的行号。-c : 仅统计并输出匹配行的总数。-r : 递归搜索子目录下的所有文件。-l : 仅列出包含匹配内容的文件名。-E : 使用扩展正则表达式 (ERE) 进行搜索。
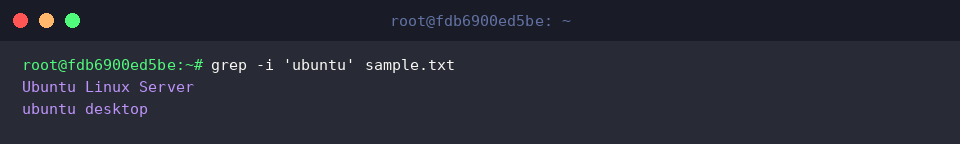
添加 -i 选项后,将在不区分大小写的情况下进行搜索。
因此,包含大写开头的 Ubuntu 和小写开头的 ubuntu 的行都会被输出。
显示行号(-n)与反转匹配搜索(-v)
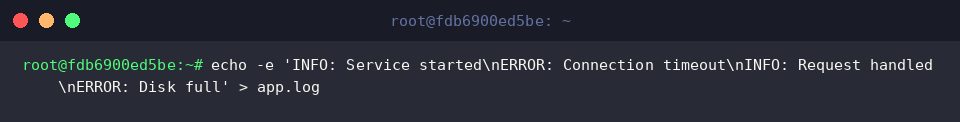
为了创建用于日志分析实战的虚拟日志数据,运行 echo -e 'INFO: Service started\nERROR: Connection timeout\nINFO: Request handled\nERROR: Disk full' > app.log 命令。
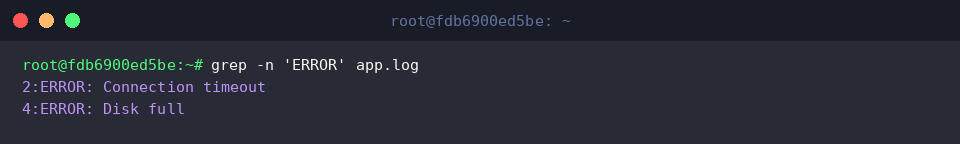
使用 -n 选项时,会同时显示与搜索模式匹配的行的行号。
包含 ERROR 字符串的行号和内容会一起输出,便于快速定位问题发生的位置。
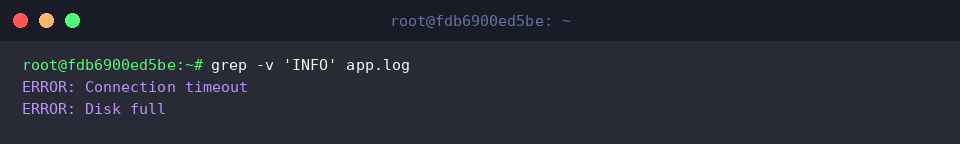
使用 -v 选项时,仅反转输出与指定模式不匹配的行。
这样可以排除表示正常状态的 INFO 条目,只筛选并查看与错误相关的行。
子目录递归搜索(-r)与仅输出文件名(-l)
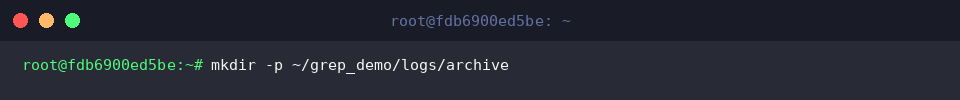
为了进行递归搜索实战并创建子归档目录结构,运行 mkdir -p ~/grep_demo/logs/archive 命令。
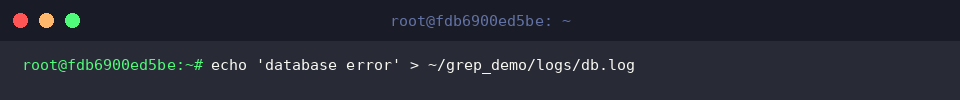
为了创建用于搜索测试的数据库错误日志文件,运行 echo 'database error' > ~/grep_demo/logs/db.log 命令。
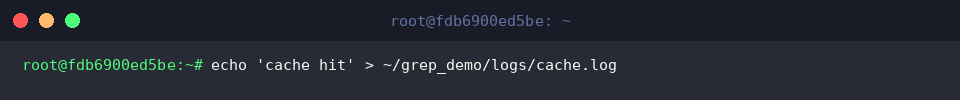
为了创建用于确认正常日志的缓存日志文件,运行 echo 'cache hit' > ~/grep_demo/logs/cache.log 命令。
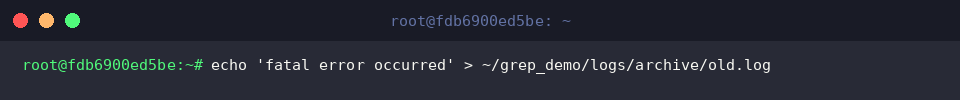
为了测试子目录遍历并创建历史错误日志文件,运行 echo 'fatal error occurred' > ~/grep_demo/logs/archive/old.log 命令。
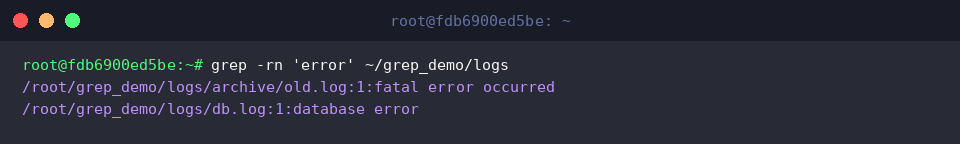
同时使用 -r 选项和 -n 选项时,可以在递归遍历子目录的同时显示匹配行的行号。
位于 logs 目录及子目录 archive 中的文件里,包含 error 字符串的文件路径、行号及内容都会被完整输出。
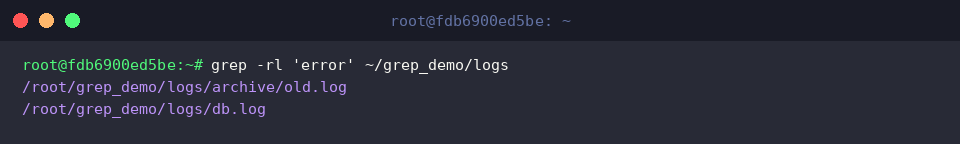
添加 -l 选项以 -rl 形式运行时,将不再输出匹配的具体内容,而是仅输出包含该模式的文件路径列表。
在众多日志文件中快速筛选出发生 error 的文件时非常有用。
查看搜索结果周边上下文(-A, -B, -C)及彩色高亮
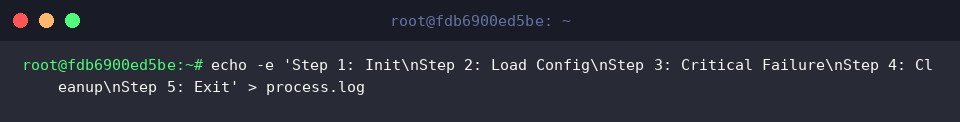
为了练习按步骤查看进程执行情况和错误上下文,运行 echo -e 'Step 1: Init\nStep 2: Load Config\nStep 3: Critical Failure\nStep 4: Cleanup\nStep 5: Exit' > process.log 命令创建示例日志文件。
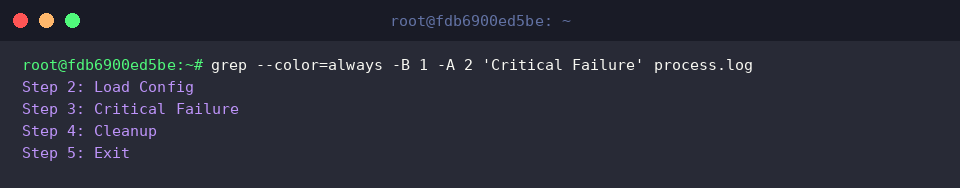
使用 -B 选项和 -A 选项时,可以以匹配行为基准,同时输出指定数量的匹配前(Before)和匹配后(After)的行。
通过 --color=always 选项对匹配的 Critical Failure 单词进行彩色高亮,同时查看前 1 行和后 2 行,有助于理清错误发生前后的工作流程。
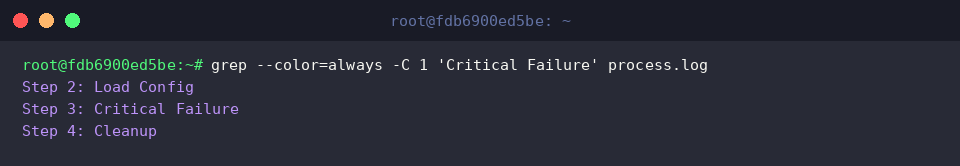
使用 -C 选项时,可以以匹配行为基准,一次性同时输出前后(Context)双向相同数量的行。
同时显示包含 Critical Failure 的上一行和下一行,可以更简洁地确认核心上下文。
以上整理了在 Ubuntu 环境下 grep 命令从基础搜索选项到实战日志分析应用的核心内容。
希望大家将今天学到的技巧积极运用到实际的终端工作中,进一步提升工作效率。