


概述
在 Linux 环境下高效处理和过滤大容量文本文件或日志数据时,awk 是最强大的工具。无需编写复杂的脚本,仅用一行命令即可实现特定列提取、条件过滤以及数据汇总。本文将介绍 awk 的核心语法及实战应用方法。
1. awk 基本工作原理与提取特定列
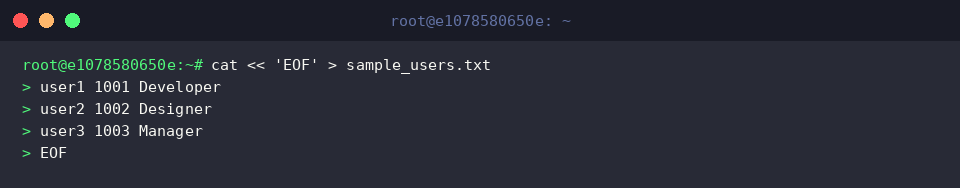
为了进行 awk 命令实践,首先创建一个以空格分隔用户名、ID 和职位信息的示例文本文件。
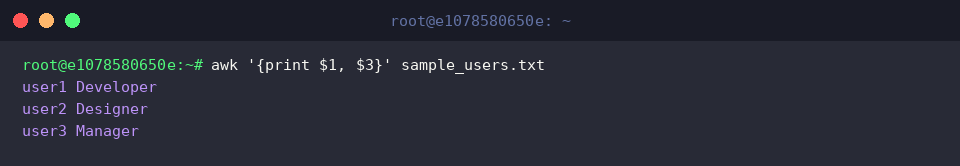
使用 awk 命令,以空格为分隔符提取并打印文件中每行的第一个字段($1,用户名)和第三个字段($3,职位)。
若未显式指定分隔符,awk 默认以连续的空格或制表符(Tab)作为字段分隔符。
⚙️ [常用选项]
-F fs : 指定输入字段分隔符(Field Separator)。-v var=val : 在执行前为 awk 脚本内部使用的变量赋初始值。-f progfile : 指定包含 awk 脚本代码的文件路径。
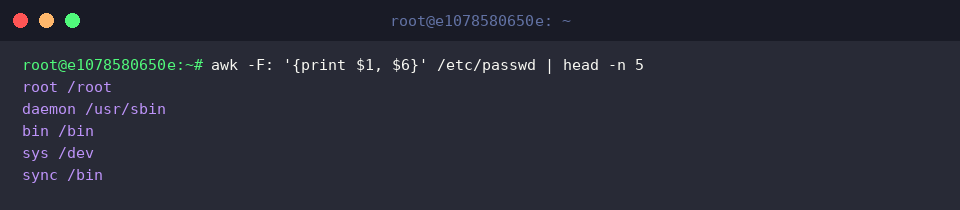
在以冒号(:)分隔的 /etc/passwd 文件中,使用 -F: 选项指定分隔符后,仅提取第一个字段($1,用户名)和第六个字段($6,家目录路径),并查看前 5 行内容。
2. 使用条件语句与运算符进行自定义数据过滤
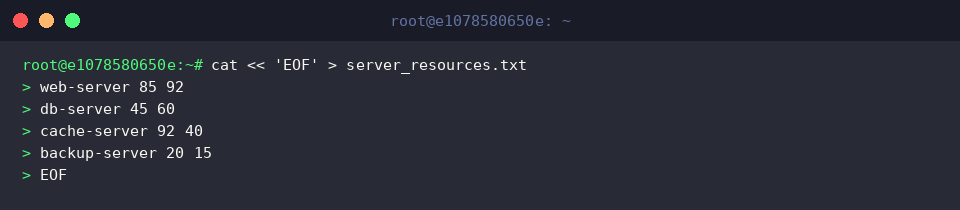
创建包含各服务器 CPU 及内存使用率数据的练习用 server_resources.txt 文件。
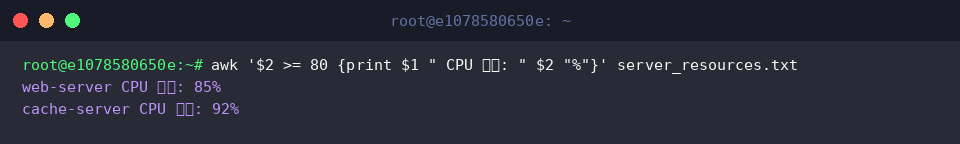
通过条件表达式筛选出第二个字段($2,CPU 使用率)大于等于 80% 的目标,并输出对应服务器名称和警告提示。
这在排查超出阈值的系统资源时非常实用。
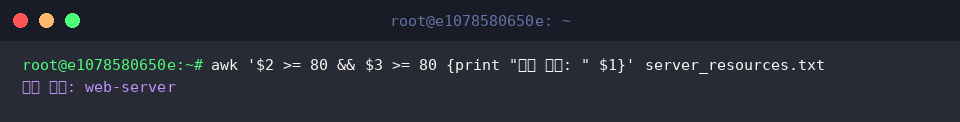
使用逻辑与运算符(&&)筛选并输出 CPU($2)和内存($3)使用率均在 80% 以上的高风险服务器。
通过应用复合条件,可以精准定位多个资源同时超过阈值的目标。
3. 使用内置变量与 BEGIN/END 块进行统计与求和
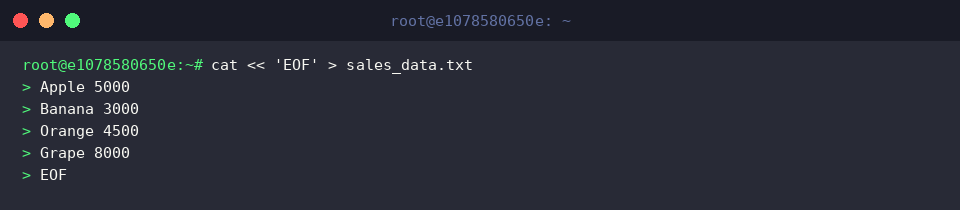
为了演示使用 awk 进行数据统计与汇总,创建一个包含商品名称和销售额的 sales_data.txt 示例文件。
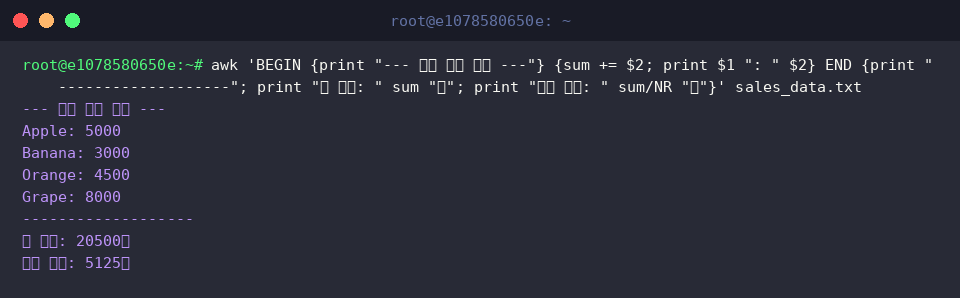
使用 BEGIN 块在处理正文之前输出统计开始提示,并将每行第二个字段($2)的值累加到变量 sum 中。
文件所有行处理完毕后执行 END 块,计算并输出总销售额以及利用内置变量 NR(总记录数)计算出的平均销售额。
4. 实战 Web 服务器日志分析与异常流量过滤
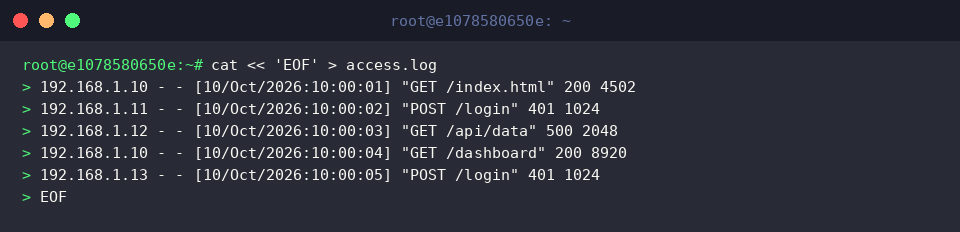
为了演示 Web 服务器日志分析与错误排查,创建一个 Nginx 和 Apache 标准格式的 access.log 示例日志文件。
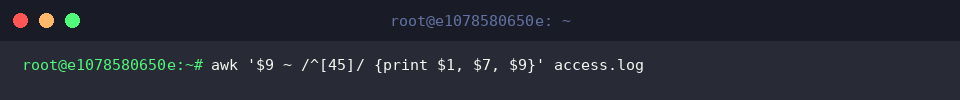
使用正则表达式匹配运算符(~),过滤出第九个字段($9,HTTP 状态码)以 4 或 5 开头的 4xx 客户端错误和 5xx 服务器错误行。
从符合条件的日志中仅提取访问 IP($1)、请求 URI($7)和状态码($9),快速排查故障及异常流量。
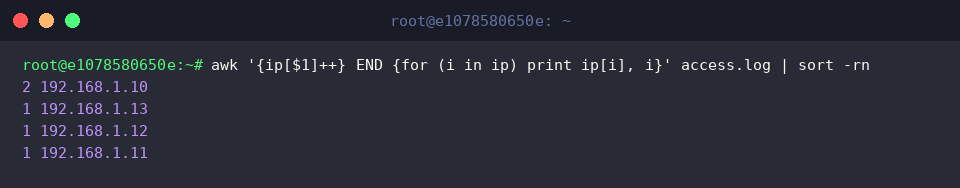
利用 awk 的关联数组(ip[$1]++)统计每个访问 IP 的请求次数,随后在 END 块中使用循环输出累计次数,并通过 sort -rn 管道按请求频次降序排列。
这是排查来自特定 IP 的异常大流量或非正常访问请求的实战分析技巧。
至此,我们简要了解了在 Linux 环境下能够轻松搞定文本处理与大容量日志分析的 awk 命令基础语法及实战核心示例。
不妨将今天介绍的各类选项和模式匹配技巧直接应用到日常运维工作中,进一步实现重复性数据提取与处理工作的高效自动化。