


核心概述
在 Linux 系统运维与日志排查工作中,处理经由 bzip2 压缩的 .bz2 归档文件是常见场景。传统做法通常需要先解压再检索,不仅大量占用额外磁盘空间,还会拖慢排查进度。借助 bzfgrep 工具,系统工程师能够直接在压缩流中定位目标纯文本(Fixed String),省去繁琐的解包开销。本文将通过一系列真实场景命令,演示如何利用该工具精准提取所需日志条目。
环境准备与测试样本构建
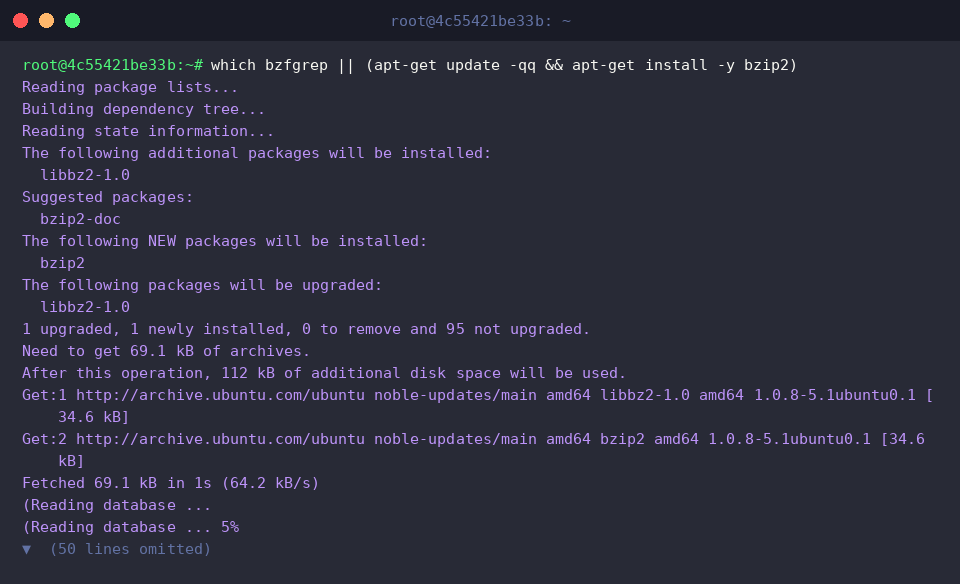
在正式使用 bzfgrep 之前,首先需确认系统已具备相关运行环境;若未预装,可通过系统包管理器安装 bzip2 基础工具包。
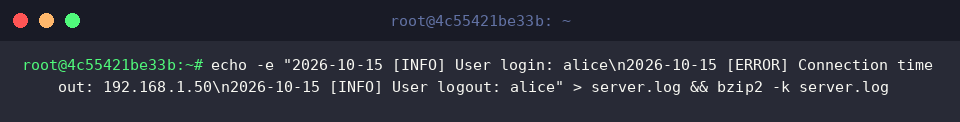
随后构建一份用于演示的模拟访问与异常日志,并利用 echo 与 bzip2 -k server.log 生成压缩文件。其中参数 -k 确保保留原始的纯文本日志,便于后续对比测试。
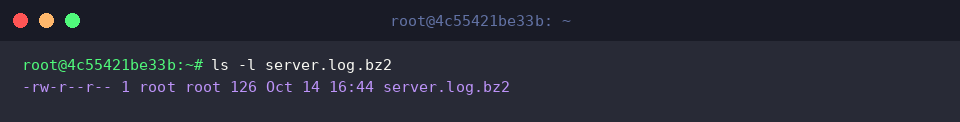
执行 ls -l server.log.bz2 查看刚生成的压缩包元数据,确认归档文件的大小、属主与读写权限均已就绪。
基础查询:直接检索压缩包内的固定字符
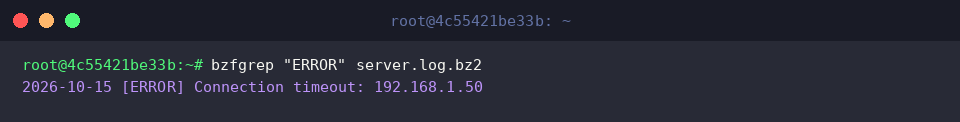
通过运行 bzfgrep,我们无需还原 server.log.bz2 的文件内容,即可直接抓取包含关键字 ERROR 的行记录。系统会在后台即时解压流并完成过滤,终端迅速输出了网络连接超时的错误日志。
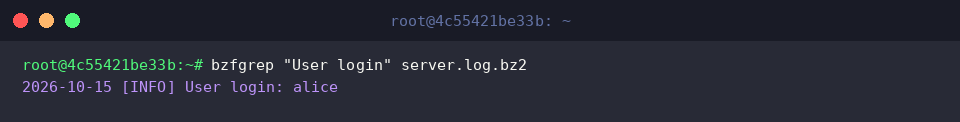
当目标短语包含空格时,只需将关键词用双引号包裹(例如 "User login")。bzfgrep 默认将其视为不可分割的字面量而非正则表达式模式,从而精确输出用户 alice 成功登录的记录。
进阶过滤参数:大小写忽略、行号标注与计数统计
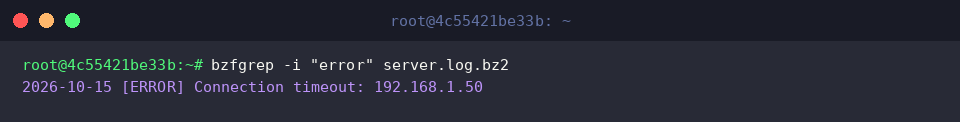
在某些排查场景下,日志关键字的大小写可能不固定。附加 -i 参数后,命令将对大小写不敏感,即使用小写的 error 也能完整捕获包含大写 [ERROR] 的日志信息。
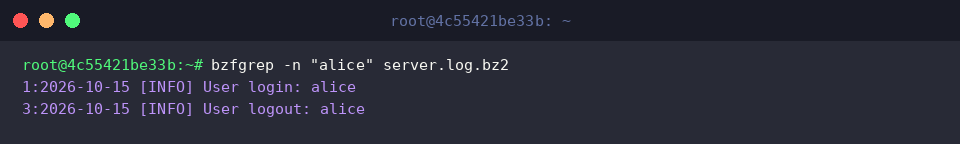
如需快速定位匹配内容在原始日志中的具体位置,可加入 -n 选项。此时针对 alice 的搜索结果行首会直观标注该记录在原文件中的对应行号。
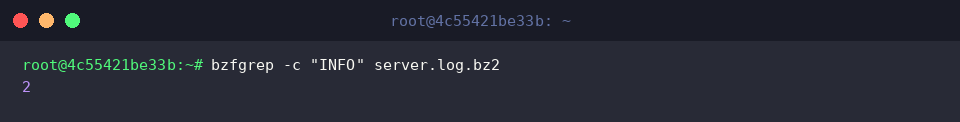
若只需要了解某种事件的发生频率而无需通篇展示具体内容,可使用 -c 开关汇总行数。执行后即可快速得知 server.log.bz2 中总共包含 2 条 INFO 级别的常规日志。
批量归档排查:跨多文件检索与文件名标识(-l 与 -H)
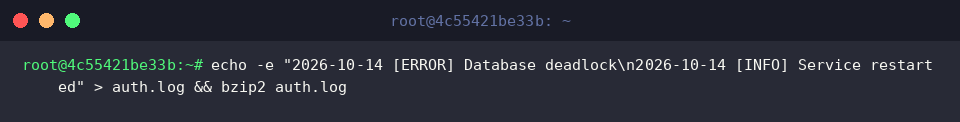
为模拟跨多日志文件的分析场景,我们补充生成一份新的认证记录并压缩成包,执行命令:echo -e "2026-10-14 [ERROR] Database deadlock\n2026-10-14 [INFO] Service restarted" > auth.log && bzip2 auth.log。
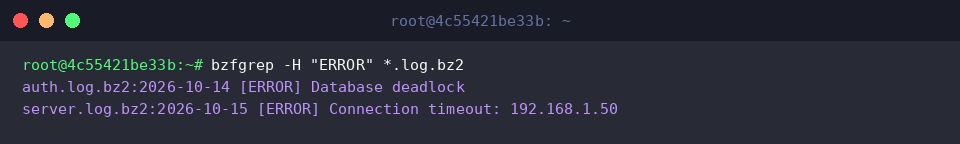
当同时对通配符指定的所有压缩包(*.log.bz2)进行扫描时,建议搭配 -H 选项,让输出结果每行显式带上归档文件名。如此一来,来自 auth.log.bz2 与 server.log.bz2 的报错来源便一目了然。
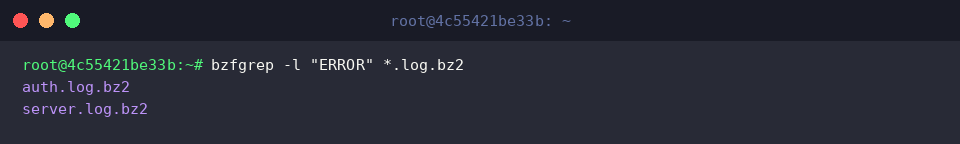
在海量历史归档中初筛异常机器或异常模块时,往往仅需锁定哪些压缩包存在问题。此时指定 -l 参数即可只返回包含 ERROR 的压缩包文件列表,极大精简了输出结果,为后续深度排查缩小目标范围。
掌握 bzfgrep 及其核心选项,能够让运维人员在面对海量 bz2 历史归档时摆脱繁重的“解压-grep-删临时文件”循环。合理结合行号、计数与文件名前缀参数,即可在节约磁盘与 IO 资源的同时,大幅提升故障定位与日志审计效率。