


概述
在Linux运维与生产环境中,系统与服务日志往往经过bzip2算法深度压缩以缩减存储占用。但如果每次排查异常都需要先解包,不仅会消耗大量的磁盘I/O与临时存储空间,排错效率也大打折扣。借助bzgrep工具,工程师能够在不解压.bz2归档的前提下直接以流式方式快速检索关键文本。本文将从实验环境搭建切入,深入演示大小写忽略、行号定位、计数统计以及多文件正则检索等核心实战技巧。
1. 搭建实验环境与生成bzip2测试日志
为了确保系统具备bzgrep工具链及压缩支持,首先执行apt-get update -qq && apt-get install -y bzip2完成bzip2套件的安装与更新。
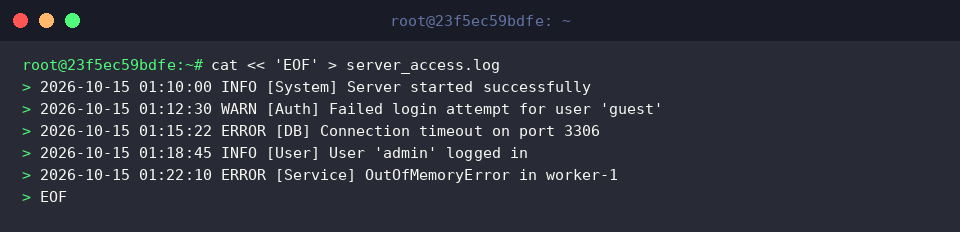
接下来准备检索演练所需的样本数据,利用cat命令创建包含不同日志级别的模拟服务日志server_access.log。
为了在压缩测试数据的同时完整保留原始日志文本,运行带有-k参数的bzip2 -k server_access.log命令完成打包。
通过ls -lh server_access.log.bz2确认.bz2压缩文件已正常生成,并检查其文件属性与存储体积。
2. bzgrep基础检索与大小写自适应匹配 (-i)
如果希望在不解包的前提下探查.bz2内部的具体报错,可直接运行bzgrep "ERROR" server_access.log.bz2。由于默认检索机制严格区分大小写,终端将仅返回与大写ERROR精确吻合的日志记录。
若日志中存在格式不统一或拼写大小写混杂的情形,附加-i参数执行bzgrep -i "error" server_access.log.bz2即可放宽匹配限制,快速汇总所有大小写形态的命中结果。
3. 定位上下文行号(-n)、统计命中频次(-c)与反向排除过滤(-v)
在定位到异常后,为了迅速明确该事件在源文件中的具体位置,可加入-n参数运行bzgrep -n "ERROR" server_access.log.bz2。每条命中日志前方均会附带真实行号,极大方便了后续精准回溯上下文。
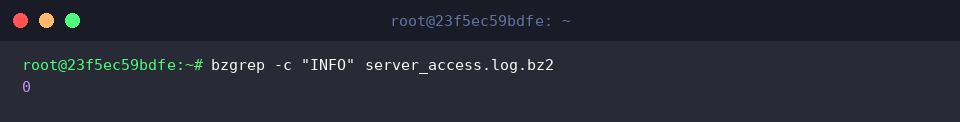
当仅需要统计某类事件的发生频次而无需展开详细内容时,启用计数开关-c执行bzgrep -c "INFO" server_access.log.bz2。系统会跳过解压阶段直接输出匹配总数,适合快速评估系统负载与事件频率。
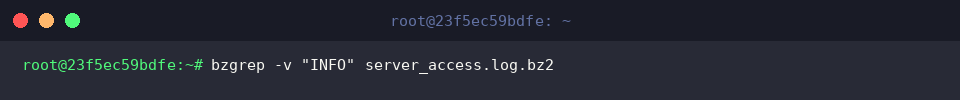
海量的日常信息日志常常掩盖关键异常,此时利用-v选项执行bzgrep -v "INFO" server_access.log.bz2进行反向筛选,能够直接剔除所有常规INFO记录,将注意力集中在值得警惕的告警与故障条目上。
4. 批量扫描多份.bz2归档与扩展正则表达式实战
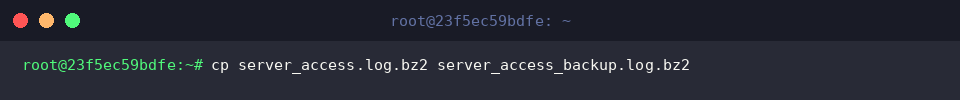
在实际运维场景中,日志多按时间轮转为多个压缩分卷。这里先使用cp server_access.log.bz2 server_access_backup.log.bz2创建一份备份副本来模拟多归档环境。
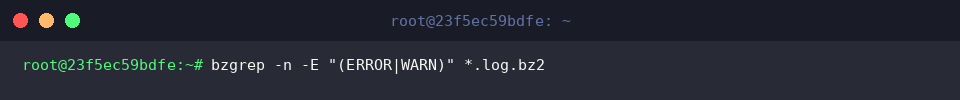
结合Shell通配符(*.log.bz2)与扩展正则参数(-E),输入bzgrep -n -E "(ERROR|WARN)" *.log.bz2即可发起跨文件批量搜索。该指令能够一次性扫描当前目录下所有的目标压缩包,快速找出带有ERROR或WARN的所有行,并同步展示对应文件名与具体行号,助力工程师高效追踪跨文件的分布式异常。
综上所述,熟练使用bzgrep可以在完全免去解压负担的同时,获得与原生grep同样强劲的查询能力。在分析海量备份或轮转归档日志时,合理应用上述选项不仅能节省可观的服务器I/O资源,更能大幅提升日常巡检与故障排查的速度。