


技术背景与核心概述
在日常运维与跨平台文件交互中,Linux 工程师常会遇到由于字符集不匹配导致的日志乱码或文本解析异常。盲目转码往往会导致数据二次损坏,因此快速、可靠地锁定源文件的实际编码格式至关重要。本文将系统讲解轻量级探测神器 chardetect 的部署过程、高阶检测实战、底层识别原理,并结合 iconv 工具演示一套闭环的乱码修复方案。
环境部署:安装与配置 chardetect 实用工具
在 Debian/Ubuntu 发行版中,该工具作为 Python 字符集探测库的命令行接口存在。我们首先同步软件源索引,并安装对应的系统组件 python3-chardet:
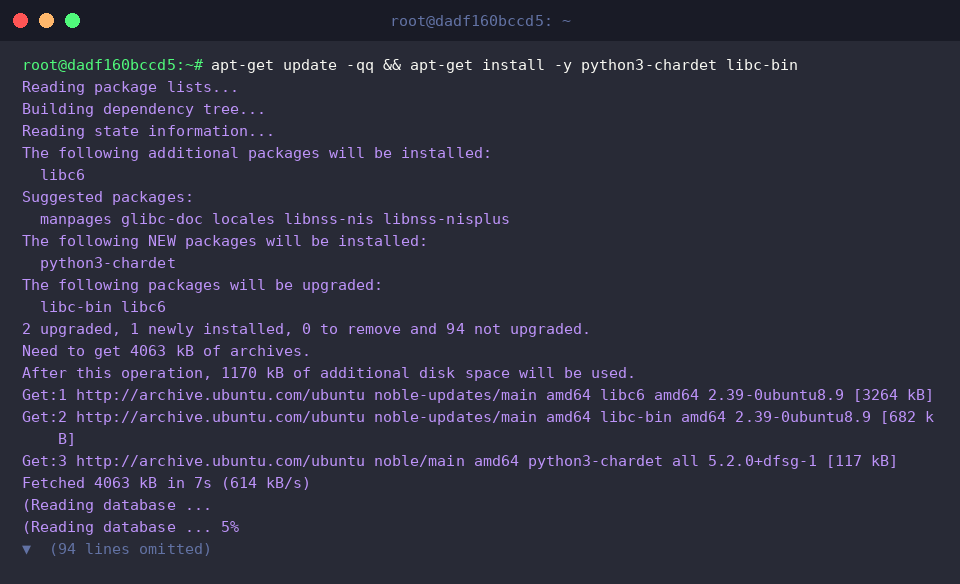
chardetect 能够智能抽样并分析文本内容或输入数据流,给出推导出的字符编码(Charset)及其置信度得分(Confidence)。
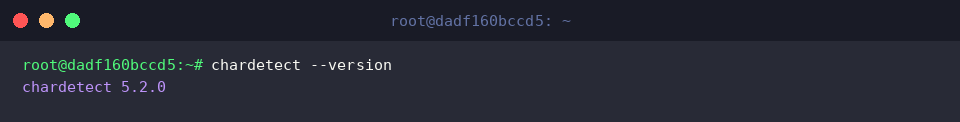
通过附加 --version 参数,可以迅速校验当前环境中安装的软件包版本信息。
⚙️ [核心参数解析]
-l, --line-per-line : 改变全篇分析模式,转为按行逐一诊断每行的字符编码。--minimal : 精简输出格式,隐去置信度概率值,仅返回识别出的编码名称。-h, --help : 调出帮助手册,列出所有支持的操作指令与详细说明。--version : 打印程序发行版本并直接退出。
动手实践:构建多编码样本并实施精准检测
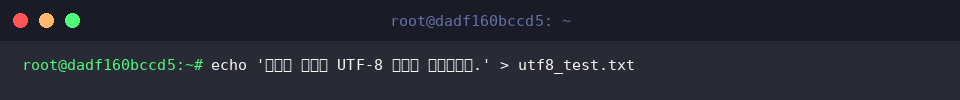
为了验证工具在不同字符集环境下的诊断准确率,我们先利用 echo 指令创建一个采用标准 UTF-8 编码的基准文件 utf8_test.txt:
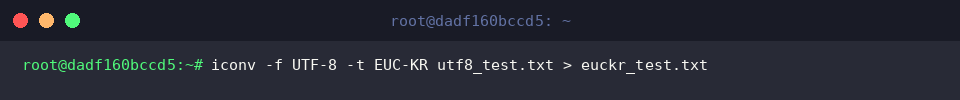
接下来借助通用转码工具 iconv,将该 UTF-8 样本转码为典型的东亚遗留字符集 EUC-KR,并导出为 euckr_test.txt 测试样本:
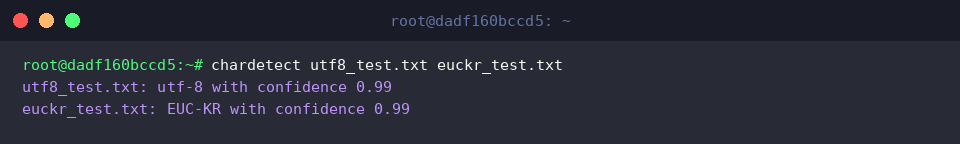
此时只需将两个目标文件以参数形式传递给 chardetect,系统即可并发进行字节特征匹配并给出评估报告。
终端反馈清晰标明:utf8_test.txt 被判定为 UTF-8,而 euckr_test.txt 则正确标识为 EUC-KR,二者的统计置信度均高达 99%(confidence: 0.99)。
进阶技巧:利用管道流与通配符进行批量探测
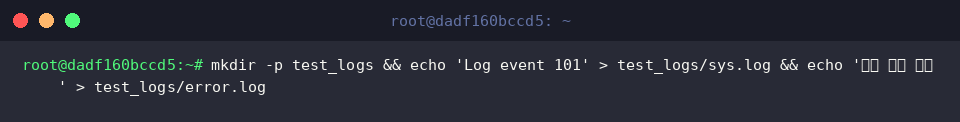
在处理动态生成的服务器日志时,工程师往往需要结合流水线命令处理未知数据流。我们先创建测试目录结构 mkdir -p test_logs && echo 'Log event 101' > test_logs/sys.log && echo '서버 에러 로그' > test_logs/error.log,生成包含纯英文与多语言字符的模拟日志文件:
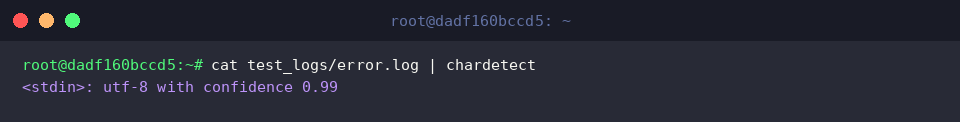
结合 cat 与管道符(|),可以直接把文本数据作为标准输入(stdin)重定向至 chardetect。
程序会敏锐地将来源标记为 <stdin>,并在无实体文件名的情况下,依然以 99% 的可信度判定内容为 UTF-8:
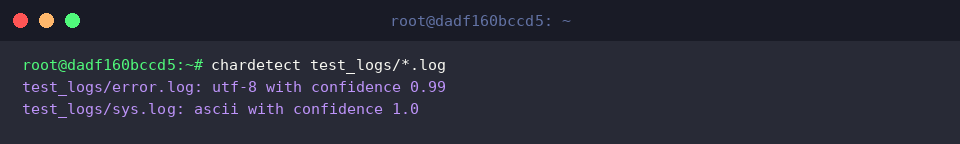
针对大型日志目录,我们可以灵活配合 Bash 通配符(*)展开批量扫描。
测试表明,包含非 ASCII 字符的 error.log 被归类为 UTF-8,而仅含基础英文字符的 sys.log 则被准确划定为纯 ASCII 范围:
底层剖析与转码实战:结合 iconv 彻底根治乱码
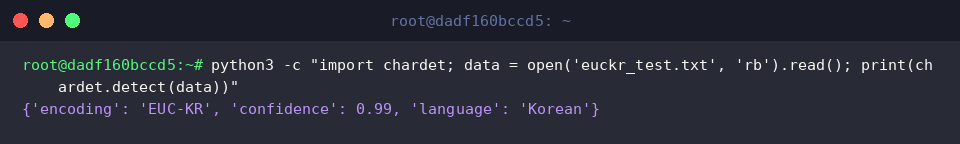
该 CLI 工具的核心算法依赖 Python 的 chardet 引擎。通过内联执行一段脚本直接读取二进制字节序列,我们可以直观洞察其内在的分析机制:
底层探测器通过统计模型计算字节分布,最终吐出一个包含识别编码(EUC-KR)、置信度系数(0.99)以及潜在语言范畴(Korean)的评估字典:
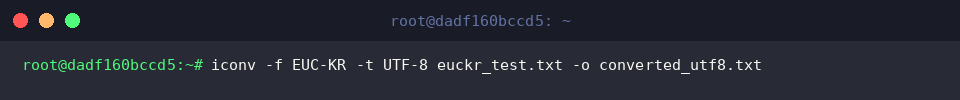
在彻底掌握源文件的字符集后,便可以借助 iconv 执行无损转码操作。我们将前述的 euckr_test.txt 转换为主流标准的 converted_utf8.txt。
其中 -f EUC-KR 明确指明输入编码,-t UTF-8 指定输出目标格式,配合 -o 选项将清洗后的数据写入新文件:
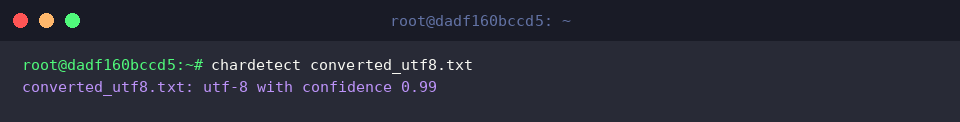
最后,再次调用 chardetect 对新生成的 converted_utf8.txt 进行回检。
结果显示新文件已完全迁移至 UTF-8 标准且置信度维持在 99%,表明乱码问题已从根源上得到解决。
熟练掌握 chardetect 的特征嗅探并搭配 iconv 进行定向转码,是 Linux 平台下高效排查乱码、保障日志可读性与数据完整性的必备技能。在日常脚本编写与数据流水线搭建中,合理引入此方案能大幅提升字符处理的稳健性。