


概述
在日常 Linux 运维与脚本开发中,快速提取两份文本之间的异同项是一项常见任务。本文将系统讲解核心文本比对工具 comm 的实操技巧。内容涵盖经典三列输出架构的解析、利用数字参数实现集合筛选(交集与差集提取),以及配合排序指令应对复杂无序文本的工程实践方案。
1. 剖析 comm 命令的工作原理与三列输出模型
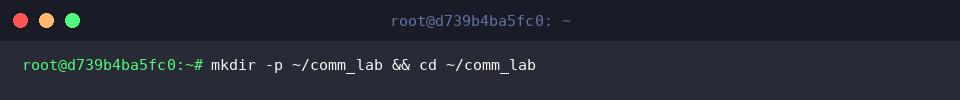
为保障测试流程规范且不污染其他目录,首先构建本次实训专属的实验环境并切入其中,执行 mkdir -p ~/comm_lab && cd ~/comm_lab 命令。
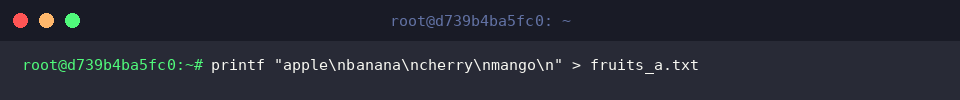
随后构建基础测试集。生成按字母升序排列的首个基准样本文件 fruits_a.txt,运行命令 printf "apple\nbanana\ncherry\nmango\n" > fruits_a.txt。
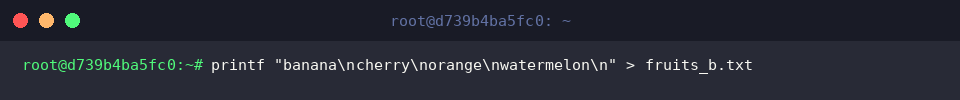
继续构建用于对照的第二个有序样本文件 fruits_b.txt,执行 printf "banana\ncherry\norange\nwatermelon\n" > fruits_b.txt。
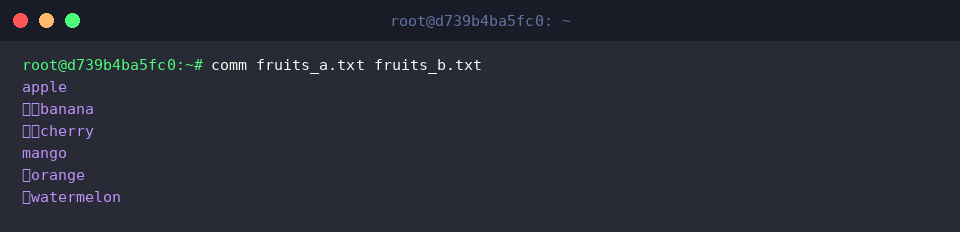
comm 工具的核心机制在于逐行扫描两份预先排好序的文本,并以经典的“三栏制表”形式呈现对比结论:
输出视图中,靠左无缩进的第 1 列归属于第一个文件特有的行;带单次制表符缩进的第 2 列归属于第二个文件专有的行;而右侧经双重制表符缩进的第 3 列则汇集双方共有的记录(即交集)。
⚙️ [核心控制选项]
-1 : 屏蔽首个文件特有数据(隐藏第 1 列)。-2 : 屏蔽第二个文件特有数据(隐藏第 2 列)。-3 : 屏蔽两文件共有数据(隐藏第 3 列)。--check-order : 严格校验输入文件的行排序状态,若无序则告警中止。--nocheck-order : 跳过对文件排列次序的合规性核验。--output-delimiter=STR : 将列与列之间的默认制表符间隔符替换为自定义文本(STR)。
2. 借助数字参数精准提取集合:交集与差集过滤技巧
开始筛选操作前,确保终端会话当前处于实验数据所在路径,运行 cd ~/comm_lab 命令。
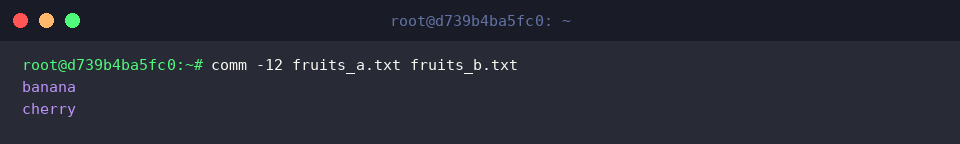
若要提取两份文本的共有行(数学意义上的交集),需屏蔽代表各自特有项的 1、2 列。执行 comm -12 即可达成该目标。
终端反馈精准列出了两个列表中均包含的 banana 与 cherry。
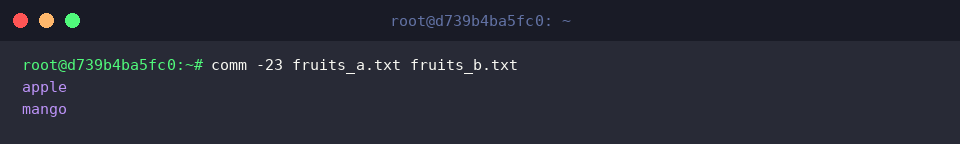
若目标是找出仅在第一个文件中出现而第二份文件缺失的条目(即 $A - B$ 相对差集),只需同时过滤掉第 2 列与第 3 列,执行 comm -23 命令。
处理后,屏幕仅展示独属于 fruits_a.txt 的 apple 和 mango。
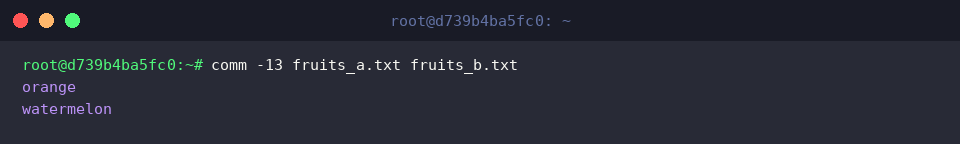
反之,若需捕获仅存在于第二份文件的新增项(即 $B - A$ 差集),则通过排除第 1 列与第 3 列实现,执行 comm -13 命令。
执行完毕后,仅有归属于 fruits_b.txt 专有的 orange 以及 watermelon 被保留打印。
3. 处理无序文件对比:巧用 Bash 进程替换避免生成临时文件
重置当前工作上下文,执行 cd ~/comm_lab 确保停留在测试目录。
为了模拟现实中常见的未经整理的数据源,先生成首个乱序数据样本 unsorted_a.txt,运行 printf "zebra\napple\ngrape\n" > unsorted_a.txt 命令。
随后构建乱序对照样本 unsorted_b.txt,执行 printf "apple\norange\nzebra\n" > unsorted_b.txt。
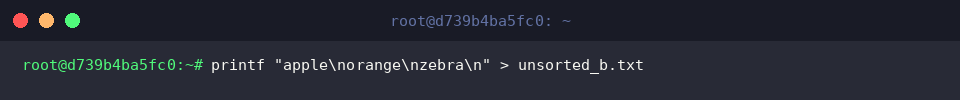
comm 默认要求输入流必须经过排序。此时无需手动生成磁盘中转文件,利用 Bash 提供的进程替换特性(<(...))即可实现流式即时排序,命令为 comm <(sort unsorted_a.txt) <(sort unsorted_b.txt)。
系统在管道内部完成排序并直接比对:第 1 列正确显示仅首文件存在的 grape,第 2 列显示仅次文件拥有的 orange,第 3 列则清晰呈现双方均具备的 apple 与 zebra。
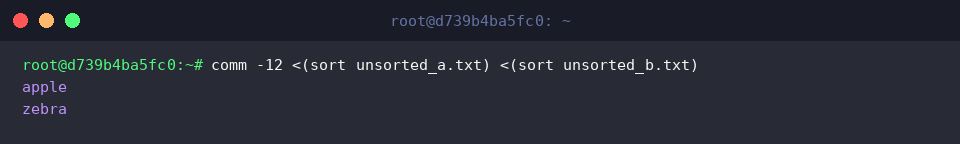
将进程替换与列过滤选项进一步结合,通过 comm -12 <(sort unsorted_a.txt) <(sort unsorted_b.txt) 命令可直接剥离所有差异行,仅留存共同记录。
在完全不改动原始磁盘文件、亦未引入中间垃圾文件的前提下,快速获得了两个混乱列表的交集元素 apple 与 zebra。
4. 生产环境实战:环境软件包差异对比与大小写忽略处理
先重申执行路径,键入 cd ~/comm_lab 返回测试根目录。
在集群环境一致性巡检场景中,常需要比对多台主机的组件差异。先建立第一台服务器的清单文件 server1_pkgs.txt,执行 printf "curl\ngit\nnginx\nvim\n" > server1_pkgs.txt。
接着创建第二台主机的软件包记录 server2_pkgs.txt 作为对照组,运行 printf "docker\ngit\npython3\nvim\n" > server2_pkgs.txt。
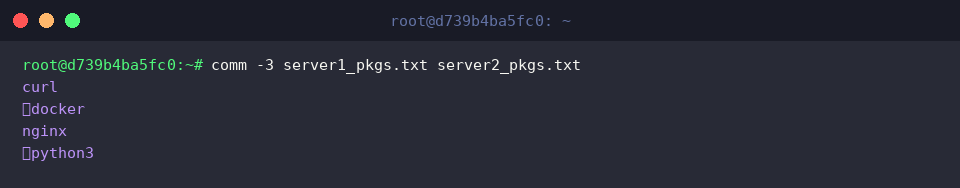
若仅关注两台主机之间的差异配置(滤除共同组件),可以使用 -3 选项过滤第 3 列交集部分,运行 comm -3 server1_pkgs.txt server2_pkgs.txt 命令。
此时,两机共有的基础工具 git 与 vim 被隐藏,仅直观输出了 Server 1 专属的 curl 与 nginx,以及 Server 2 独有的 docker 和 python3。
另外,字符大小写差异在字符串比对中也是常见变量。为演示其边界行为,先生成含大小写混杂的测试文件 mixed_a.txt,执行 printf "Apple\nBANANA\ncherry\n" > mixed_a.txt。
紧接着创建与其字符相同但大小写格式相异的对照文本 mixed_b.txt,运行 printf "apple\nbanana\nCHERRY\n" > mixed_b.txt。
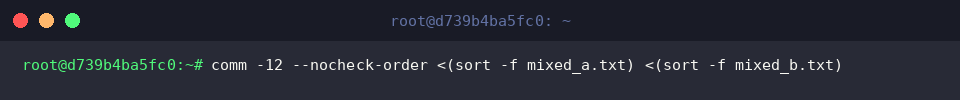
尝试使用 comm -12 --nocheck-order <(sort -f mixed_a.txt) <(sort -f mixed_b.txt) 进行提取。虽然借助 sort -f 实现了忽略大小写的排序规则,并补充 --nocheck-order 规避了校验中断,但依然无法获取共有行。
这是因为 comm 的核心比对逻辑严格依赖逐字节的精确匹配。尽管输入流的排列次序被调整一致,但由于实际字符 ASCII 码值不相等,两份文件在底层依然被视作毫无交集,因此最终输出为空白。
综上所述,Linux 中的 comm 命令凭借其轻量级的三列过滤架构,为系统管理员与开发人员提供了极其高效的集合运算利器。掌握其与 sort 管道及进程替换的组合方案,能在海量配置核验、日志分析以及依赖审计等日常任务中大幅提升处理效率。